Gemma 4 E2B로 멀티모달 AI 어시스턴트 만들기 — Ollama + LangChain + Gradio
로컬에서 구동되는 2.3B 파라미터 모델로 웹 검색, 이미지 분석, 음성 인식까지. API 키 없이 완성하는 멀티모달 AI 어시스턴트 실전 구축기.
들어가며
2026년, 구글이 Gemma 4를 발표했다. 오픈 가중치 모델이면서 비전(Vision) 기능을 기본 탑재한 것이 핵심이었다. 특히 E2B(2.3B effective params) 모델은 가벼우면서도 도구 호출(Tool Calling)을 지원해, 로컬 환경에서 멀티모달 에이전트를 구축하기에 적합했다.
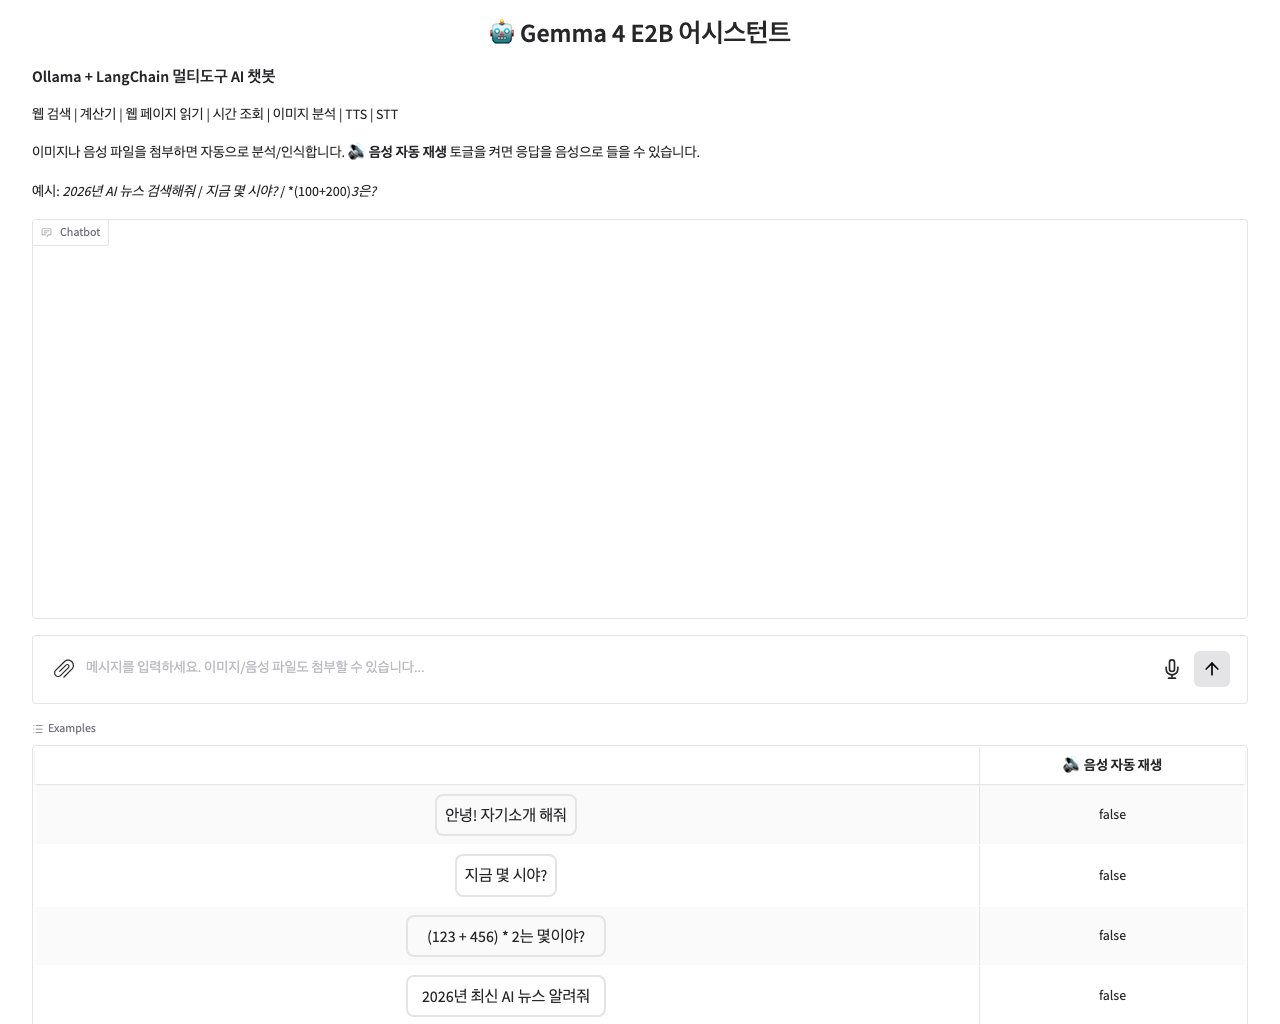
이 글에서는 Gemma 4 E2B + Ollama + LangChain + Gradio 조합으로 7개 도구를 사용하는 멀티모달 AI 어시스턴트를 구축하는 전 과정을 정리한다. 모든 기능은 Playwright로 통합테스트를 진행했고, 실제 동작 화면을 스크린샷과 영상으로 첨부했다.
| 기술 스택 | 역할 |
|---|---|
| Gemma 4 E2B (Ollama) | 로컬 LLM (2.3B, Vision 지원) |
| LangChain | 에이전트 프레임워크 + 도구 바인딩 |
| Gradio 6 | 멀티모달 채팅 UI |
완성된 어시스턴트의 초기 화면:
아키텍처
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
사용자 (텍스트 + 이미지/음성)
        │
        ▼
  Gradio ChatInterface (multimodal=True)
        │
        ▼
  predict() 함수
  ├── 파일 처리: 이미지 분석 / 음성 인식
  ├── History → LangChain Messages 변환
  └── ReAct 에이전트 루프 (최대 8회)
        │
        ▼
  ChatOllama (gemma4:e2b) + Tool Binding
        │
        ├── duckduckgo_search  → 웹 검색
        ├── read_webpage       → URL 내용 읽기
        ├── calculator         → 수학 계산
        ├── get_current_time   → 현재 시간
        ├── text_to_speech     → TTS (gTTS)
        ├── analyze_image      → 이미지 분석 (Vision)
        └── speech_to_text     → 음성 인식 (Google STT)
1. 환경 설정
Ollama로 Gemma 4 설치
1
2
3
4
5
6
# Gemma 4 E2B 모델 다운로드 (약 7.2GB)
ollama pull gemma4:e2b

# 설치 확인
ollama list
# gemma4:e2b    7fbdbf8f5e45    7.2 GB
Python 의존성
1
2
3
pip install langchain langchain-ollama langchain-community \
  ddgs beautifulsoup4 requests gTTS Pillow \
  SpeechRecognition pydub gradio
2. 도구 정의 (7개)
LangChain의 @tool 데코레이터로 도구를 정의한다. Gemma 4는 이 도구들의 스키마를 자동으로 인식한다.
2-1. 웹 검색 — DuckDuckGo
API 키가 필요 없는 DuckDuckGo 검색을 사용했다.
1
2
3
from langchain_community.tools import DuckDuckGoSearchRun

search_tool = DuckDuckGoSearchRun()
2-2. 웹 페이지 읽기
BeautifulSoup으로 HTML에서 텍스트를 추출한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
@tool
def read_webpage(url: str) -> str:
    """주어진 URL의 웹 페이지 텍스트 내용을 읽어옵니다."""
    import requests
    from bs4 import BeautifulSoup
    resp = requests.get(url, timeout=10, headers={
        "User-Agent": "Mozilla/5.0 (compatible; bot)"
    })
    resp.raise_for_status()
    soup = BeautifulSoup(resp.text, "html.parser")
    for tag in soup(["script", "style", "nav", "footer"]):
        tag.decompose()
    return soup.get_text(separator="\n", strip=True)[:3000]
2-3. 계산기
eval() 기반이지만 허용 문자 집합으로 입력을 검증한다.
1
2
3
4
5
6
7
@tool
def calculator(expression: str) -> str:
    """수학 계산을 수행합니다. 예: (2 + 3) * 4"""
    allowed = set("0123456789+-*/.() ")
    if not all(c in allowed for c in expression):
        return "지원하지 않는 문자가 포함되어 있습니다."
    return f"결과: {eval(expression)}"
2-4. 현재 시간
1
2
3
4
5
@tool
def get_current_time(timezone: str = "Asia/Seoul") -> str:
    """현재 날짜와 시간을 반환합니다."""
    now = datetime.datetime.now()
    return f"현재 시간: {now.strftime('%Y년 %m월 %d일 %H시 %M분 %S초')}"
2-5. 텍스트 → 음성 (TTS)
gTTS를 사용해 한국어 음성 파일을 생성한다.
1
2
3
4
5
6
7
@tool
def text_to_speech(text: str, output_path: str = "output.mp3") -> str:
    """텍스트를 음성(MP3) 파일로 변환합니다."""
    from gtts import gTTS
    tts = gTTS(text=text, lang='ko')
    tts.save(output_path)
    return f"음성 파일이 {output_path}에 저장되었습니다."
2-6. 이미지 분석 (Vision)
Gemma 4의 비전 기능을 활용한다. 이미지를 Base64로 인코딩하여 multimodal 메시지로 전송한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
@tool
def analyze_image(image_path: str, question: str = "이 이미지를 설명해주세요") -> str:
    """이미지 파일을 분석합니다."""
    import base64
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode()

    ext = image_path.lower().split(".")[-1]
    mime_map = {"jpg": "jpeg", "jpeg": "jpeg", "png": "png",
                "gif": "gif", "webp": "webp"}
    mime = mime_map.get(ext, "jpeg")

    message = HumanMessage(content=[
        {"type": "image_url",
         "image_url": {"url": f"data:image/{mime};base64,{image_b64}"}},
        {"type": "text", "text": question}
    ])
    response = llm.invoke([message])
    return response.content
2-7. 음성 → 텍스트 (STT)
Google Speech Recognition으로 한국어 음성을 인식한다.
1
2
3
4
5
6
7
8
9
@tool
def speech_to_text(audio_path: str) -> str:
    """음성 파일(WAV)을 텍스트로 변환합니다."""
    import speech_recognition as sr
    recognizer = sr.Recognizer()
    with sr.AudioFile(audio_path) as source:
        audio = recognizer.record(source)
    text = recognizer.recognize_google(audio, language="ko-KR")
    return f"인식된 텍스트: {text}"
3. ReAct 에이전트 구현
LangGraph 대신 직관적인 for 루프로 에이전트를 구현했다. 가독성과 디버깅이 쉽다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
llm = ChatOllama(model="gemma4:e2b", temperature=0.7)
llm_with_tools = llm.bind_tools(all_tools)
tool_map = {t.name: t for t in all_tools}

def run_agent_stream(messages):
    """에이전트 실행 + 진행 상황 yield"""
    for step in range(8):
        response = llm_with_tools.invoke(messages)
        messages.append(response)

        # 도구 호출이 없으면 최종 답변
        if not response.tool_calls:
            yield response.content, None
            return

        # 도구 실행
        tool_names = [tc["name"] for tc in response.tool_calls]
        progress = f"도구 호출 중: {', '.join(tool_names)}"

        for tc in response.tool_calls:
            tool = tool_map.get(tc["name"])
            result = tool.invoke(tc["args"]) if tool else "알 수 없는 도구"
            messages.append(
                ToolMessage(content=str(result), tool_call_id=tc["id"])
            )

        yield None, progress

    yield "최대 도구 호출 횟수를 초과했습니다.", None
핵심 흐름:
- LLM이 도구 호출을 결정하면
response.tool_calls에 정보가 담긴다 - 각 도구를 실행하고
ToolMessage로 결과를 전달한다 - LLM이 도구 호출 없이 응답하면 그것이 최종 답변이다
- 최대 8회까지 반복한다
4. Gradio 멀티모달 채팅 UI
4-1. ChatInterface 설정
Gradio 6의 multimodal=True를 사용하면 이미지/음성 파일 업로드와 마이크 녹음을 지원하는 채팅 UI를 쉽게 만들 수 있다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
demo = gr.ChatInterface(
    fn=predict,
    multimodal=True,
    textbox=gr.MultimodalTextbox(
        file_count="multiple",
        file_types=["image", "audio"],
        sources=["upload", "microphone"],
        placeholder="메시지를 입력하세요. 이미지/음성 파일도 첨부할 수 있습니다...",
    ),
    title="🤖 Gemma 4 E2B 어시스턴트",
    description=(
        "### Ollama + LangChain 멀티도구 AI 챗봇\n"
        "웹 검색 | 계산기 | 웹 페이지 읽기 | 시간 조회 | 이미지 분석 | TTS | STT"
    ),
)
4-2. multimodal 메시지 처리
multimodal=True를 설정하면 predict()의 message 파라미터가 dict 형식으로 변경된다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
def predict(message, history):
    # message = {"text": "이 이미지 설명해줘", "files": ["/tmp/xxx/image.png"]}

    user_text = message.get("text", "")
    user_files = message.get("files", [])

    # 파일 처리
    for file_path in user_files:
        ext = os.path.splitext(file_path)[1].lower()
        if ext in (".png", ".jpg", ".jpeg", ".gif", ".webp"):
            # 이미지 → Vision 모델로 분석
            analysis = analyze_image.invoke({
                "image_path": file_path,
                "question": user_text or "이 이미지를 설명해주세요"
            })
            # 분석 결과를 텍스트로 에이전트에 전달
            file_context_parts.append(f"[이미지 분석 결과]\n{analysis}")
        elif ext in (".wav", ".mp3", ".ogg"):
            # 음성 → STT로 텍스트 변환
            stt_result = speech_to_text.invoke({"audio_path": file_path})
            file_context_parts.append(f"[음성 인식 결과]\n{stt_result}")
4-3. 생각 과정 표시
에이전트의 도구 호출 과정을 <details> 태그로 접을 수 있게 표시한다. 파일 처리와 도구 호출 단계마다 yield로 중간 결과를 전달한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
def predict(message, history):
    thinking_log = []

    # 파일 처리 중 진행 상황 표시
    for file_path in user_files:
        thinking_log.append("이미지 분석 중...")
        yield _build_thinking_html(thinking_log, open_tag=True)
        # ... 파일 처리 ...
        thinking_log.append("이미지 분석 완료")

    # 에이전트 실행 중 도구 호출 표시
    for answer, progress in run_agent_stream(lc_messages):
        if progress:
            thinking_log.append(progress)
            yield _build_thinking_html(thinking_log, open_tag=True)

    # 최종 답변
    yield thinking_html + final_answer
5. 실제 동작 시연 (통합테스트)
Playwright로 모든 기능을 순차적으로 테스트했다. 각 기능별 실제 응답 화면을 확인해보자.
5-1. 자기소개
“안녕! 자기소개 해줘”
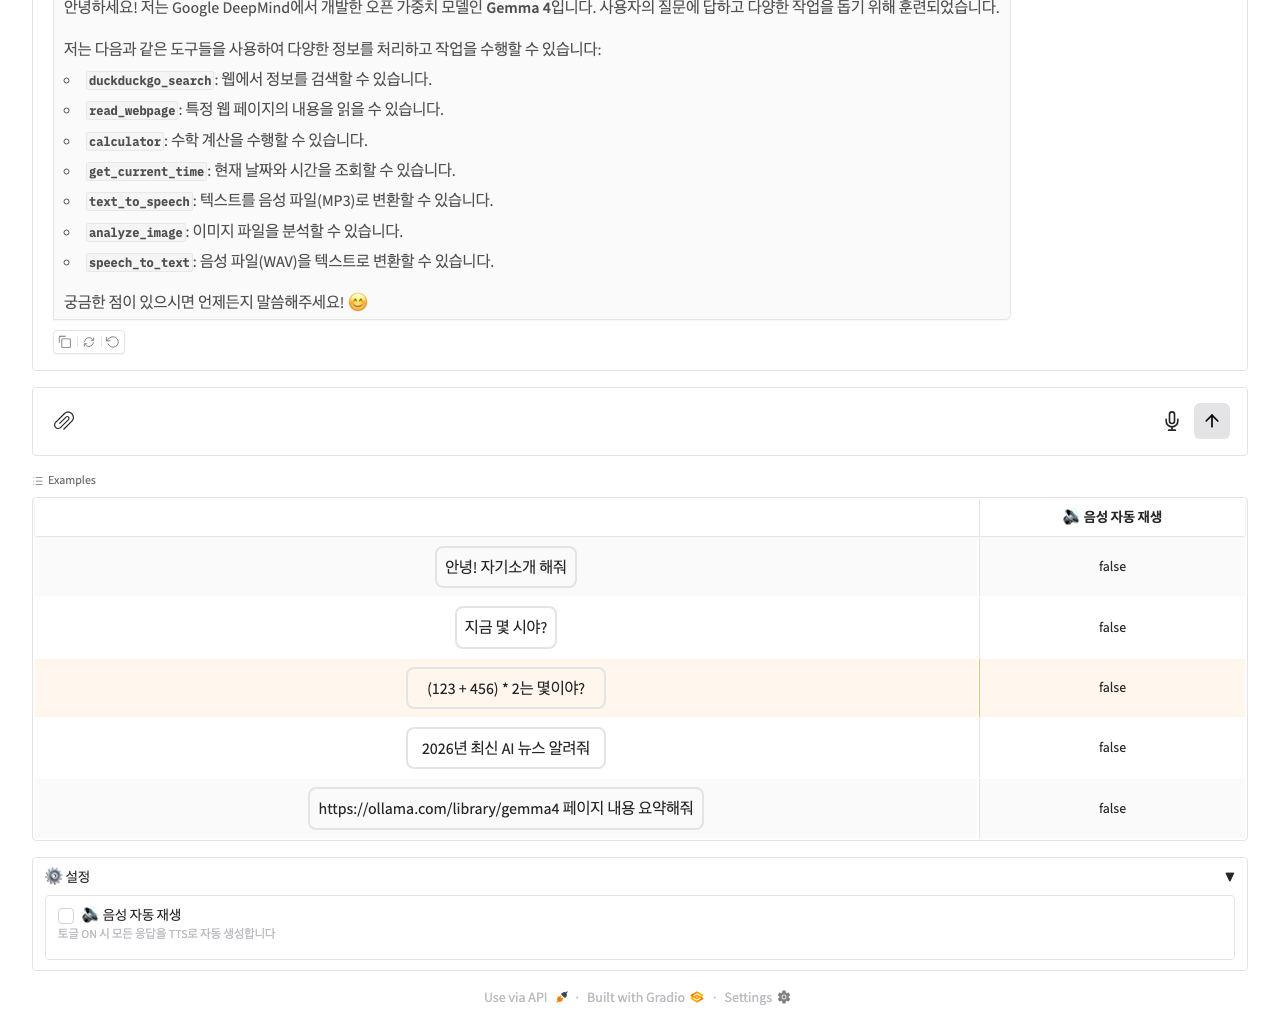
Gemma 4 E2B가 자신의 정체와 가능한 역할을 한국어로 자연스럽게 소개한다.
5-2. 현재 시간 조회 — get_current_time 도구
“지금 몇 시야?”
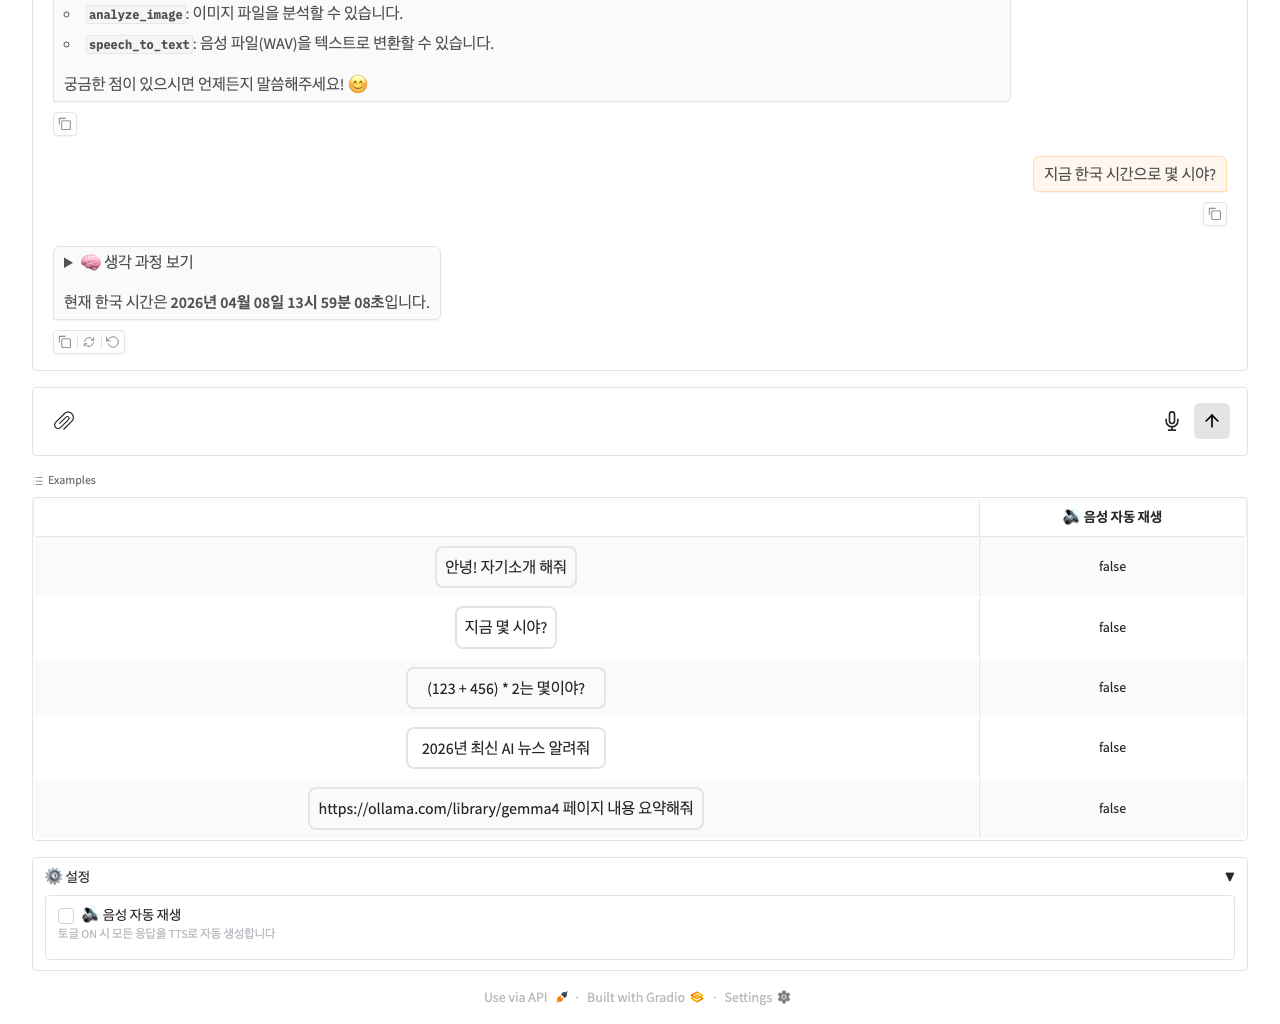
LLM이 “현재 시간” 질문을 인식하고 get_current_time 도구를 호출한 뒤, 그 결과를 자연어로 정리해 응답한다. 에이전트의 도구 호출 → 결과 반영 → 자연어 응답 흐름이 잘 나타난다.
5-3. 계산기 — calculator 도구
“(123 + 456) * 2는 몇이야?”
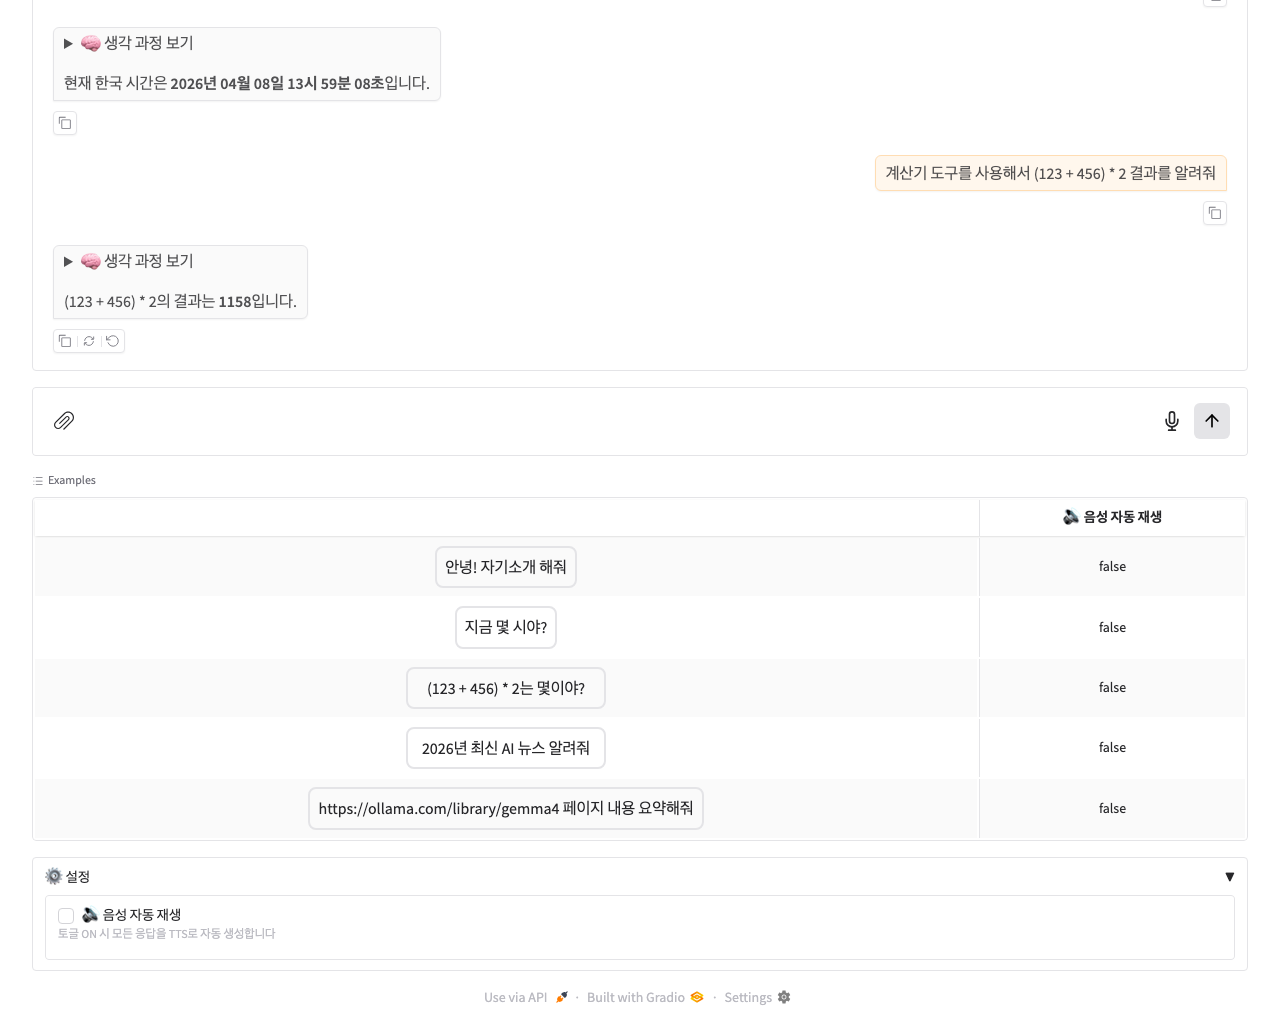
수식을 calculator 도구에 전달하고, 정확한 계산 결과 1158을 최종 답변에 반영한다. 2.3B 모델이 스스로 계산하지 않고 도구를 호출하는 것이 핵심이다.
5-4. 웹 검색 — duckduckgo_search 도구
“2026년 최신 AI 뉴스 알려줘”
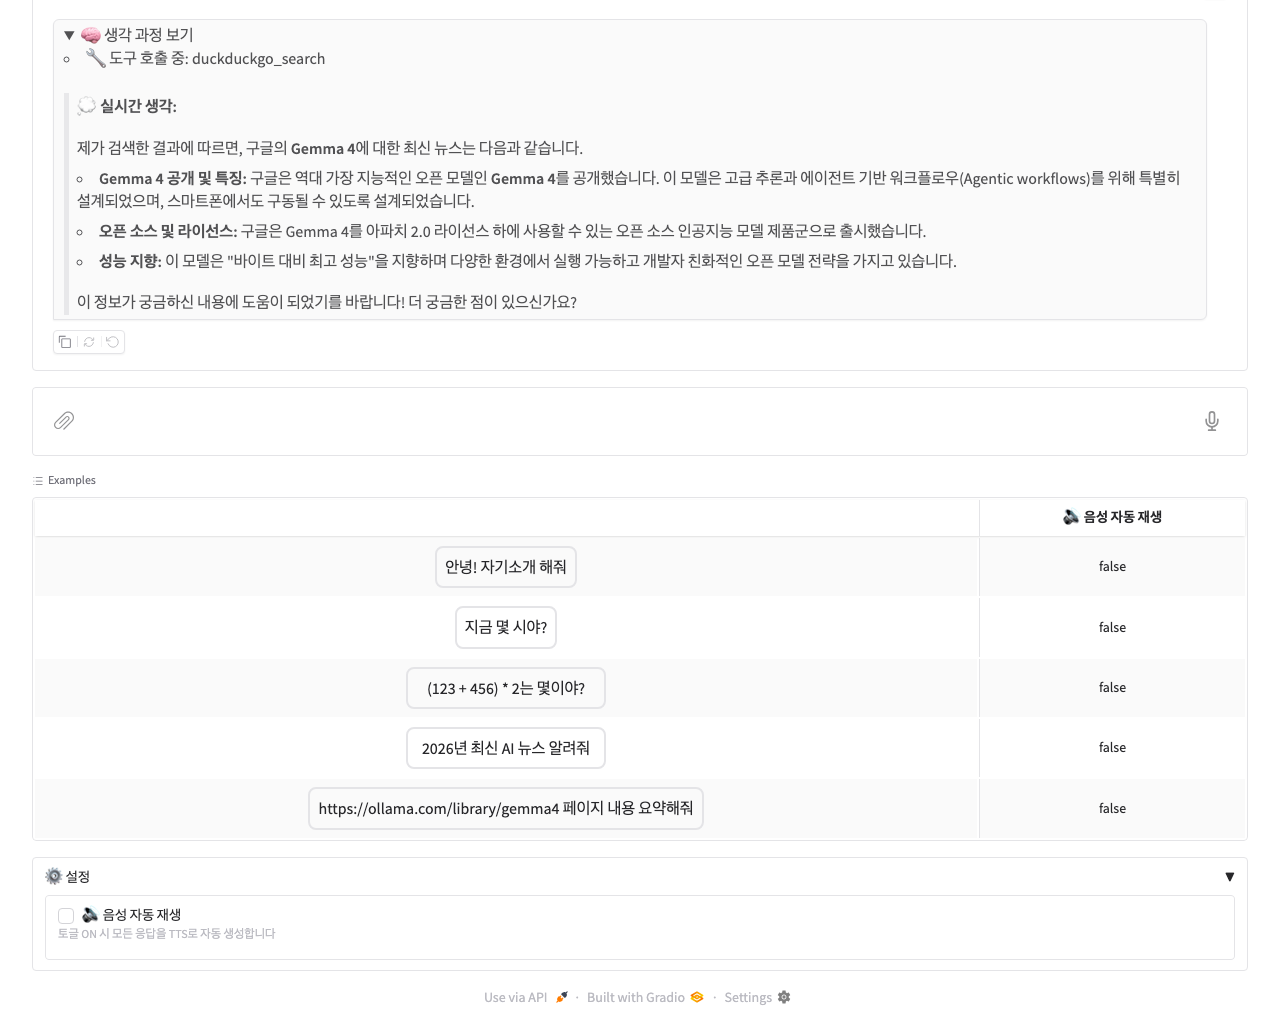
DuckDuckGo 검색 도구를 호출해 실시간 웹 검색 결과를 가져온 뒤, 이를 한국어로 요약해 응답한다. API 키 없이 로컬에서 실시간 정보를 검색할 수 있다.
5-5. 웹 페이지 읽기 — read_webpage 도구
“https://ollama.com/library/gemma4 페이지 내용 요약해줘”
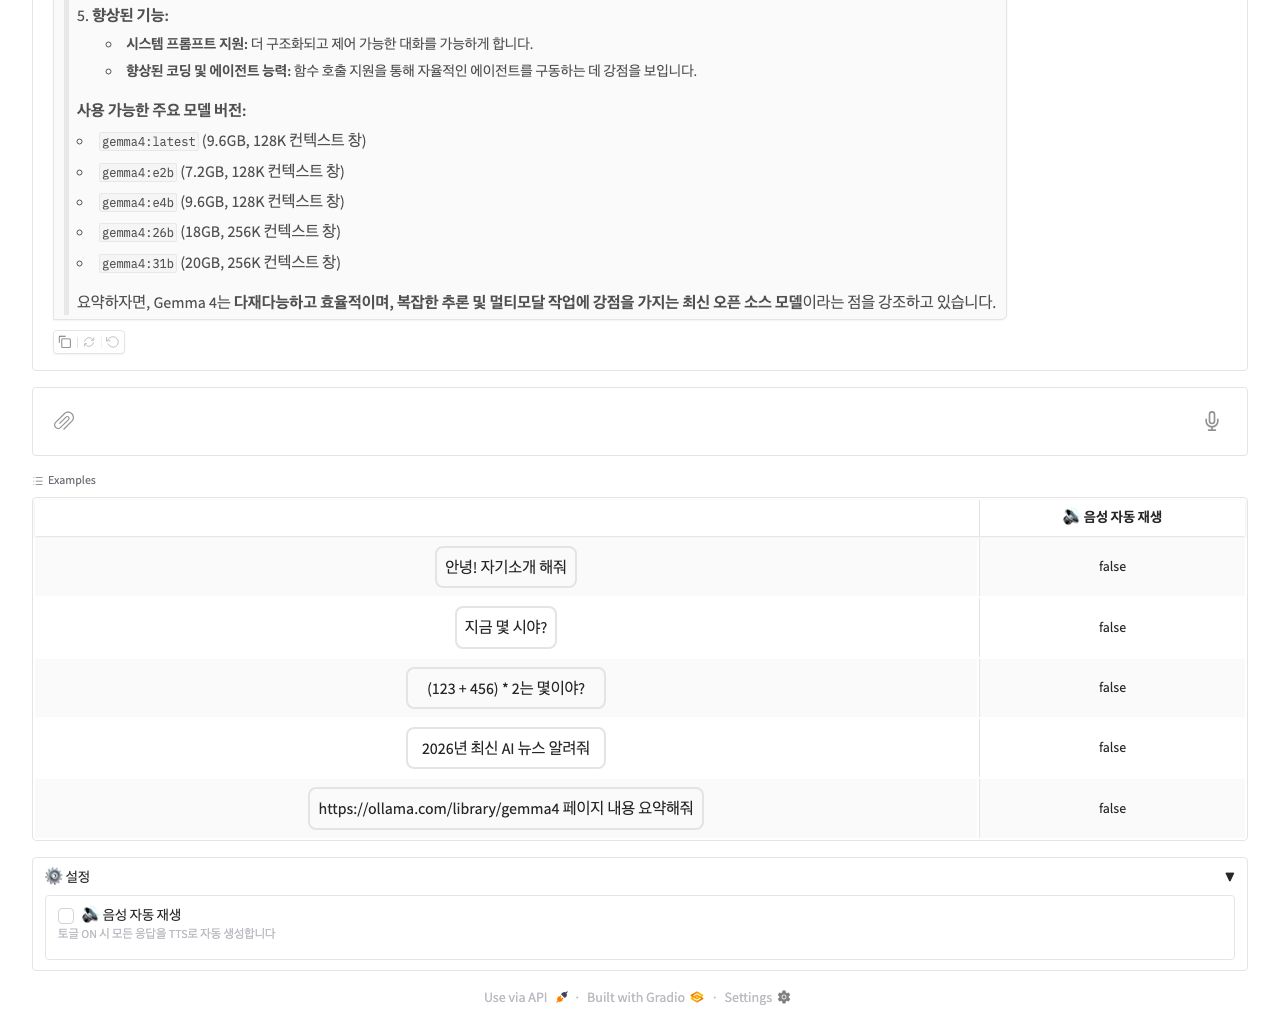
URL을 인식해 read_webpage 도구를 호출하고, BeautifulSoup으로 추출한 페이지 내용을 요약해서 전달한다.
5-6. 이미지 분석 — analyze_image 도구 (Vision)
테스트 이미지를 Gradio의 파일 업로드로 첨부하고 분석을 요청했다.
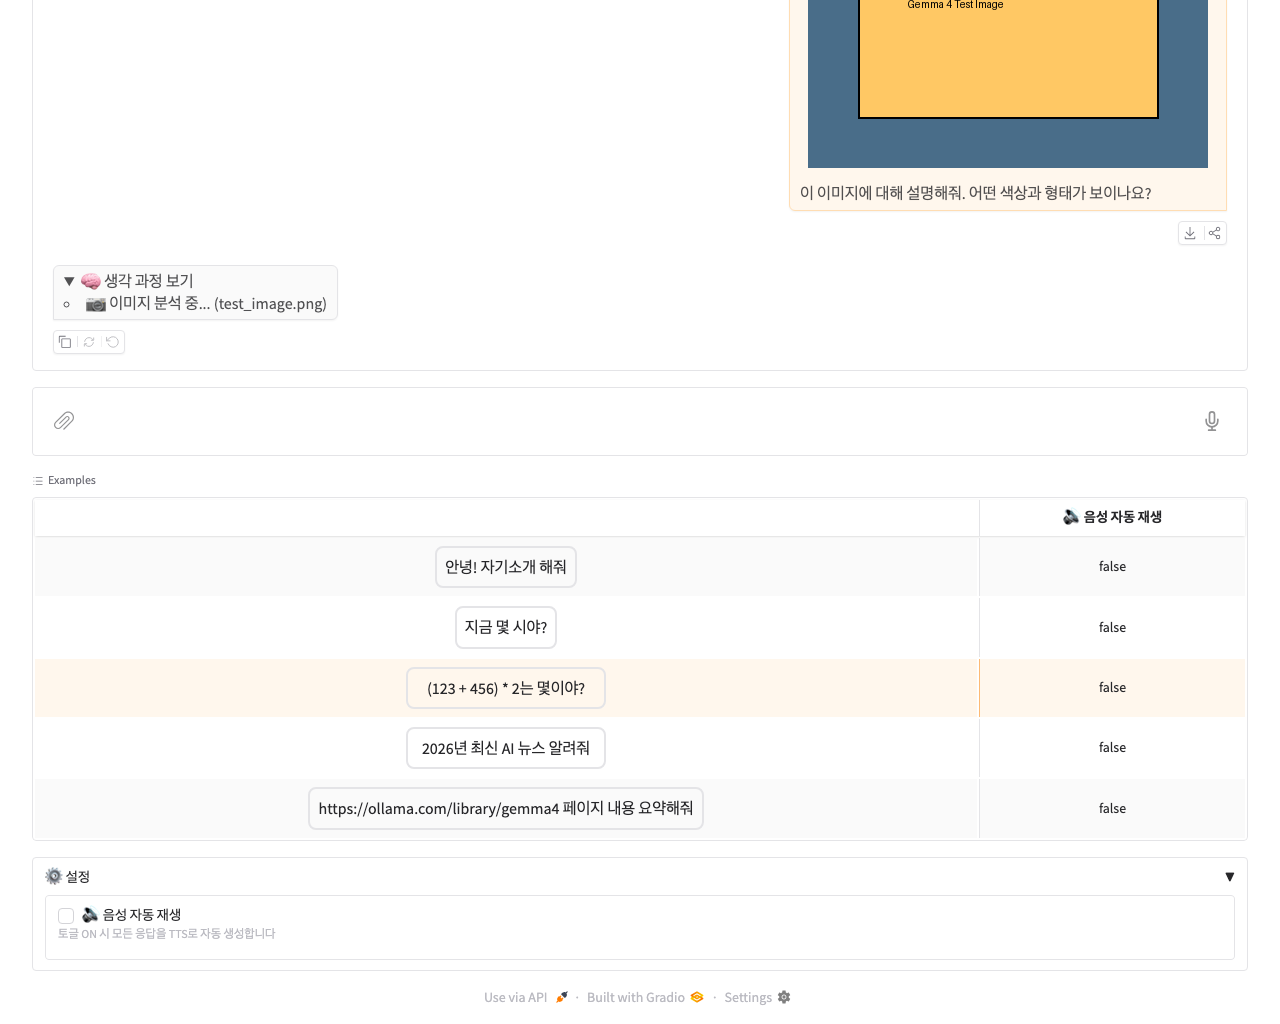
Gemma 4의 비전(Vision) 기능이 동작하는 핵심 순간이다. 사용자가 이미지를 업로드하면:
- Gradio가 파일을 임시 경로에 저장
analyze_image도구가 이미지를 Base64로 인코딩하여 multimodal 메시지 생성- LLM이 이미지를 시각적으로 분석하여 텍스트로 응답
<details> 태그 안에 “이미지 분석 중…” 진행 상황이 표시된다.
5-7. 음성 인식 — speech_to_text 도구 (STT)
gTTS로 생성한 한국어 음성(“안녕하세요 오늘 날씨가 정말 좋네요”)을 WAV 파일로 업로드했다.
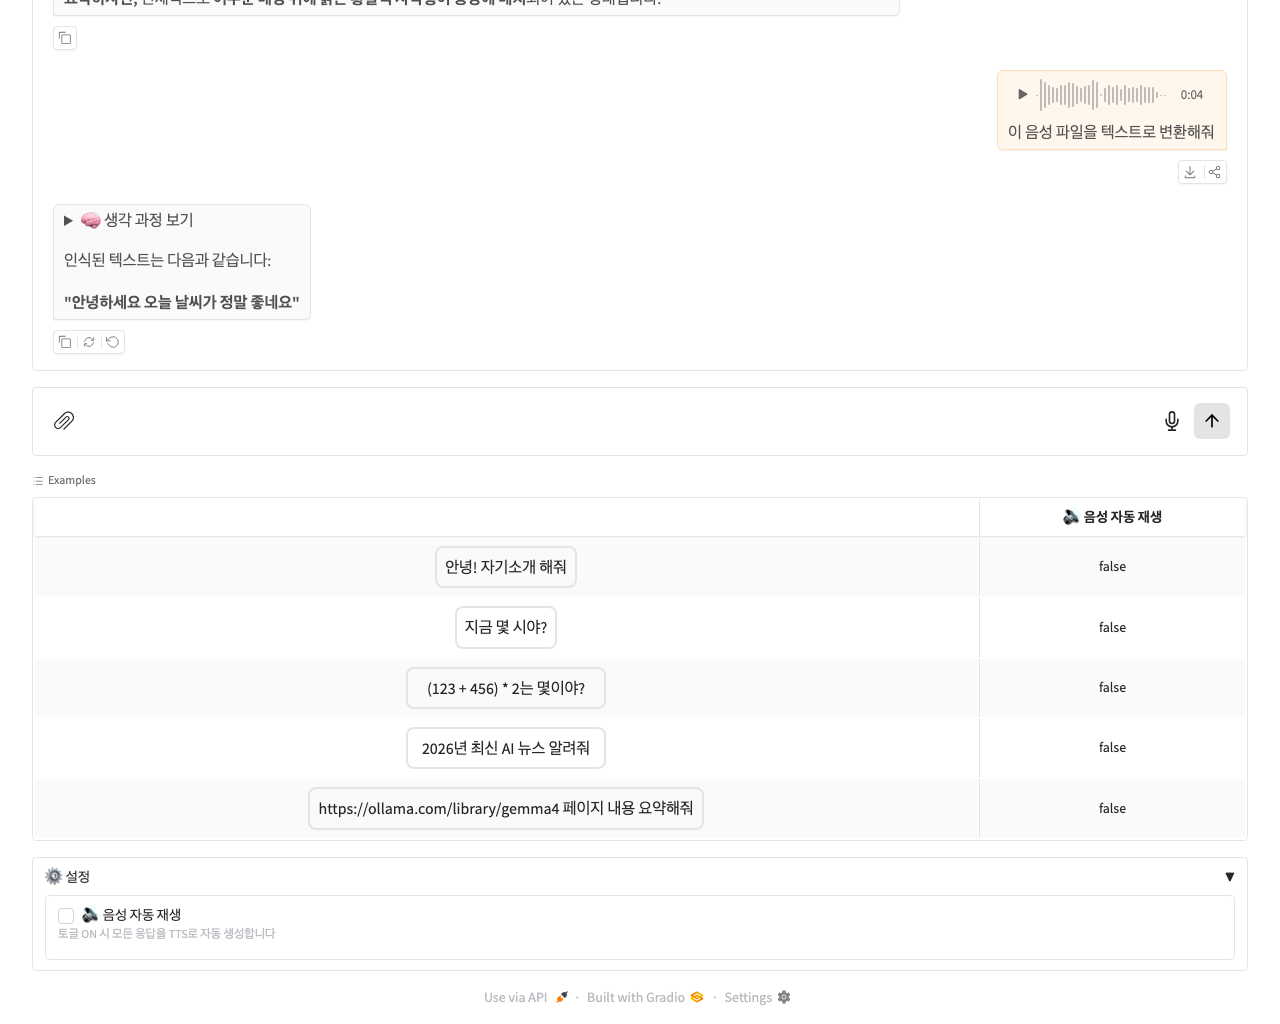
Google Speech Recognition API가 한국어 음성을 텍스트로 변환한다. Gradio의 multimodal=True 설정 덕분에 오디오 파일도 이미지와 동일한 방식으로 업로드할 수 있다.
5-8. 텍스트 음성 변환 — text_to_speech 도구 (TTS)
“안녕하세요 반갑습니다 라는 텍스트를 음성 파일로 변환해줘”
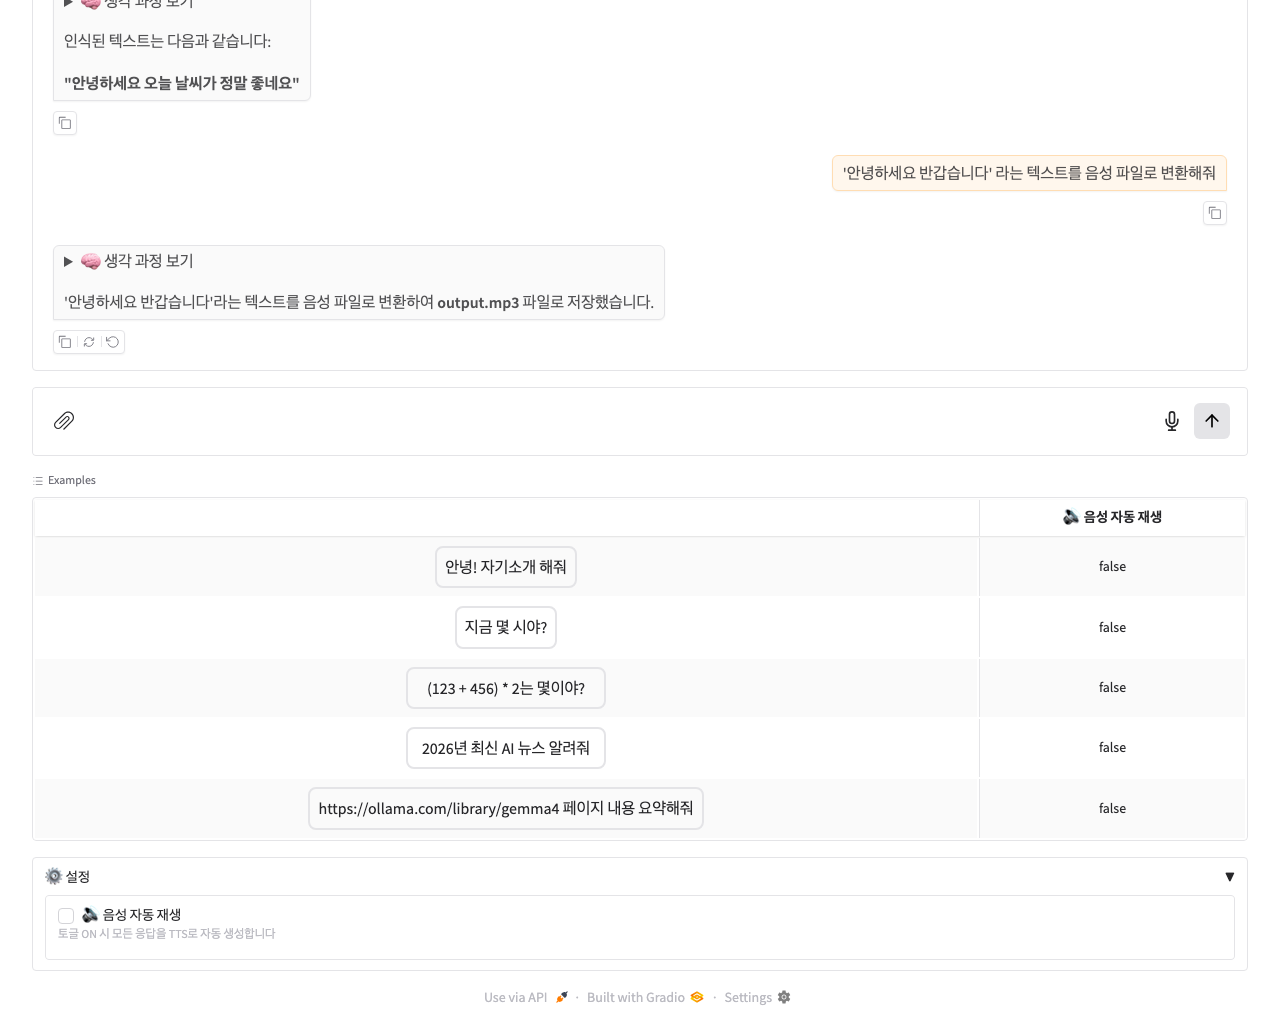
text_to_speech 도구가 gTTS를 사용해 한국어 MP3 파일을 생성한다. 2.3B 모델이 도구를 인식하고 직접 호출하는 것이 핵심이다 — 모델 스스로 TTS를 수행하는 것이 아니라 외부 도구에 위임한다.
5-9. 멀티모달 전체 오버뷰
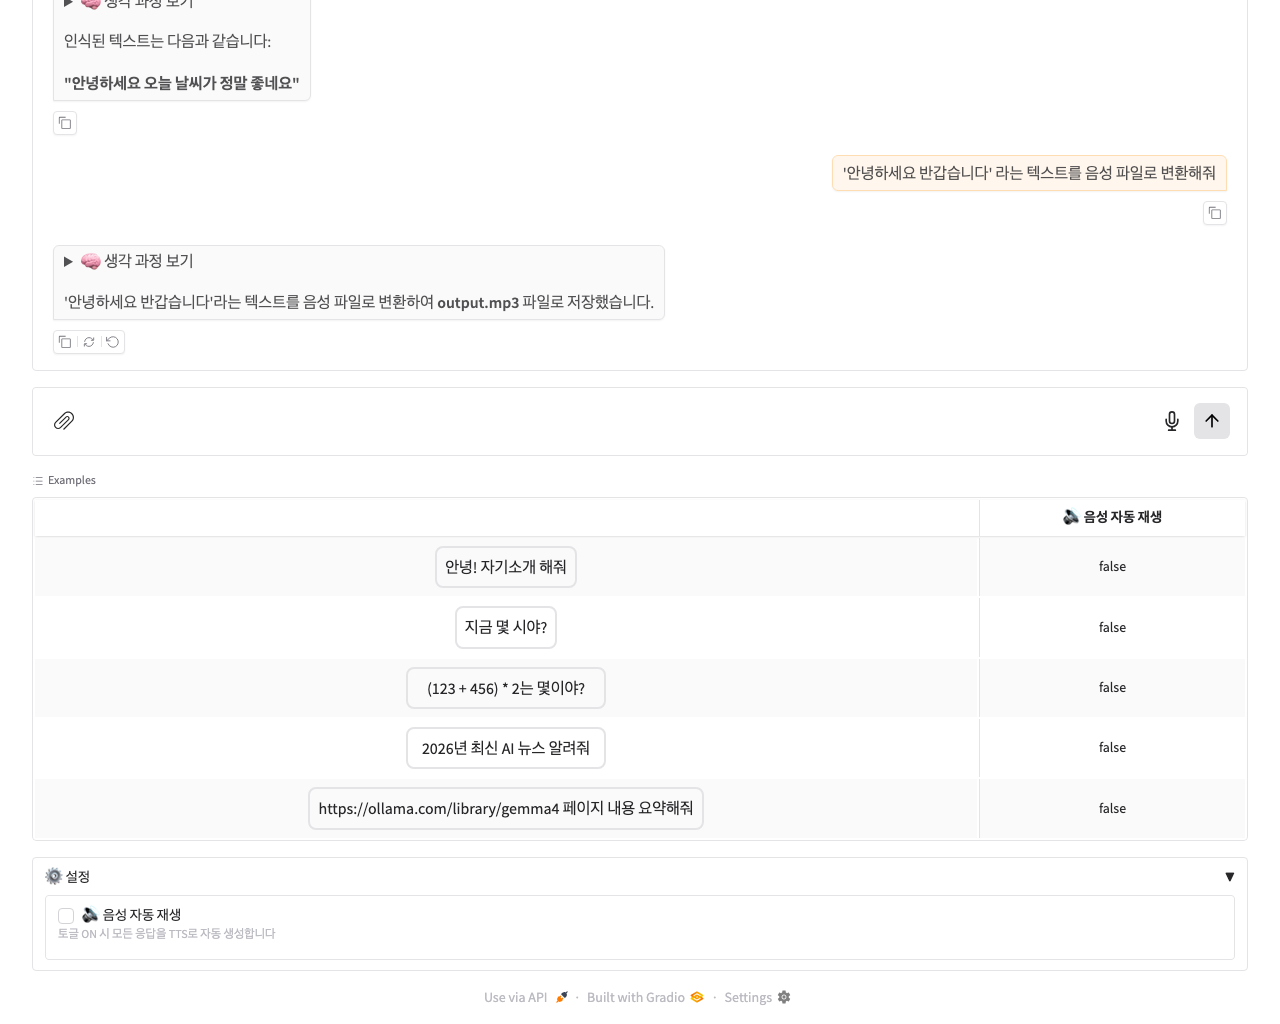
텍스트, 이미지, 오디오가 하나의 세션에서 자연스럽게 섞여 동작하는 것을 볼 수 있다. 이것이 멀티모달 AI 어시스턴트의 핵심 가치다.
5-10. TTS 자동 재생 토글
Gradio ChatInterface의 additional_inputs를 활용해 음성 자동 재생 토글을 추가했다.
토글 OFF 상태:
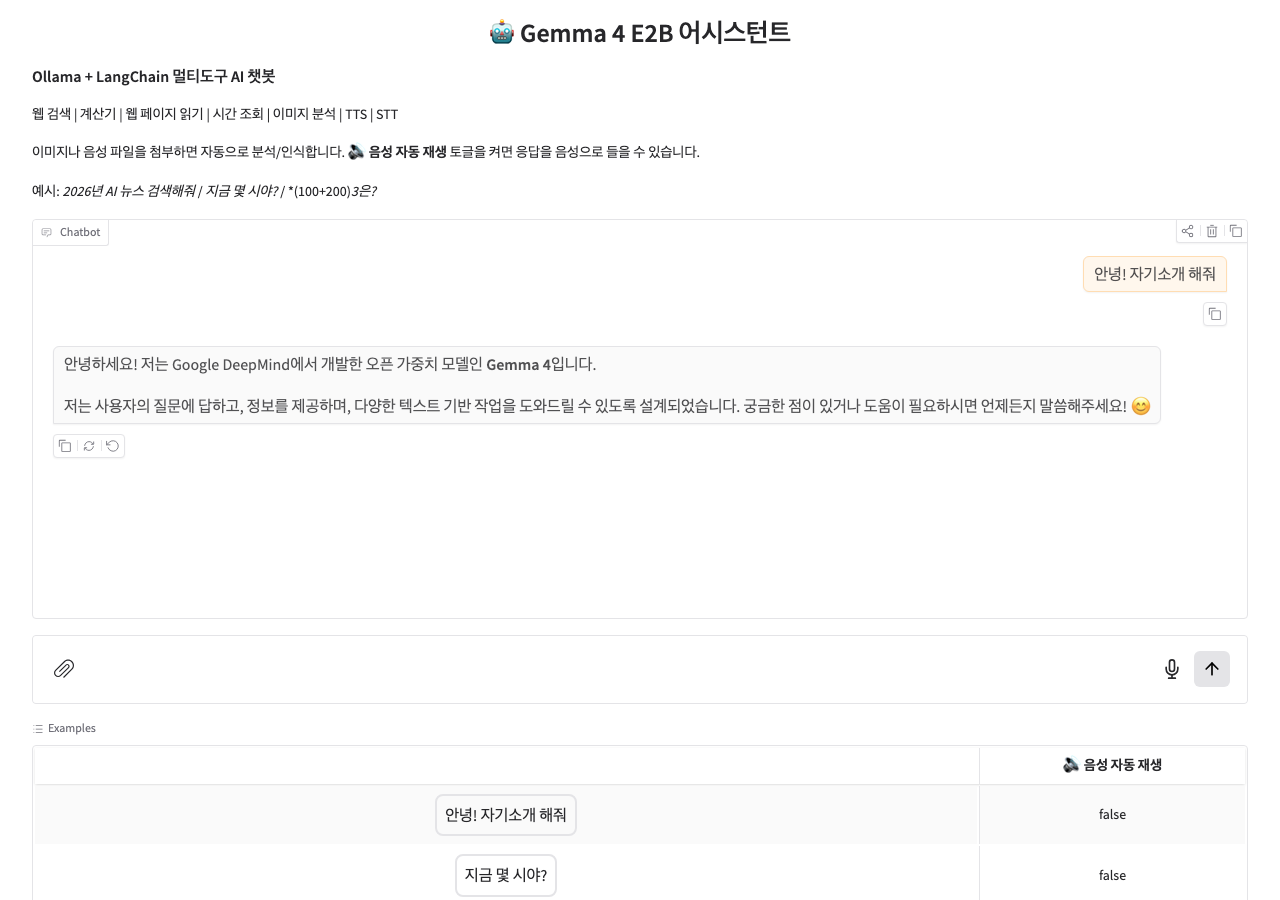
일반적인 텍스트 응답만 표시된다.
토글 ON 상태:
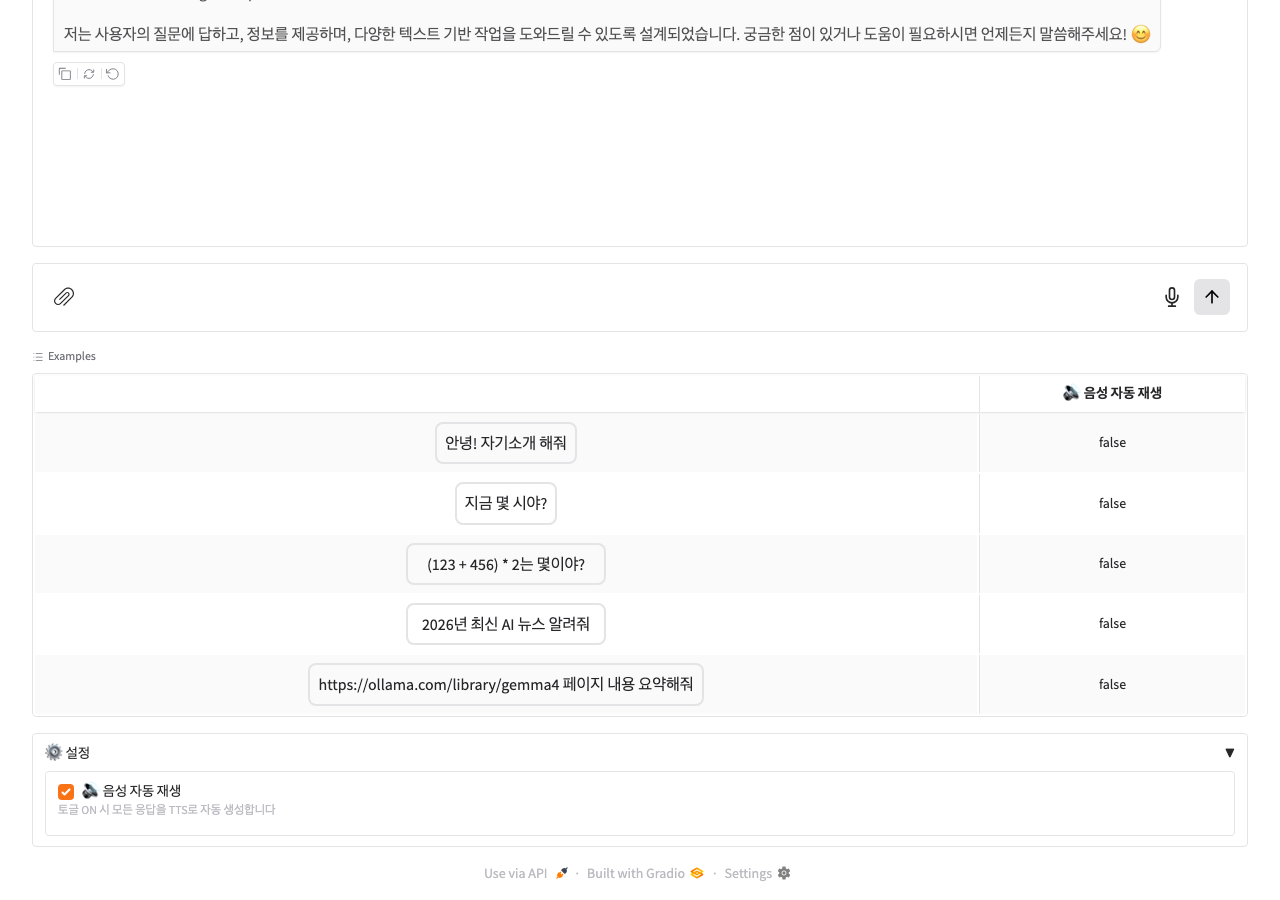
체크박스를 켜면 ⚙️ 설정 아코디언에서 활성화 상태를 확인할 수 있다.
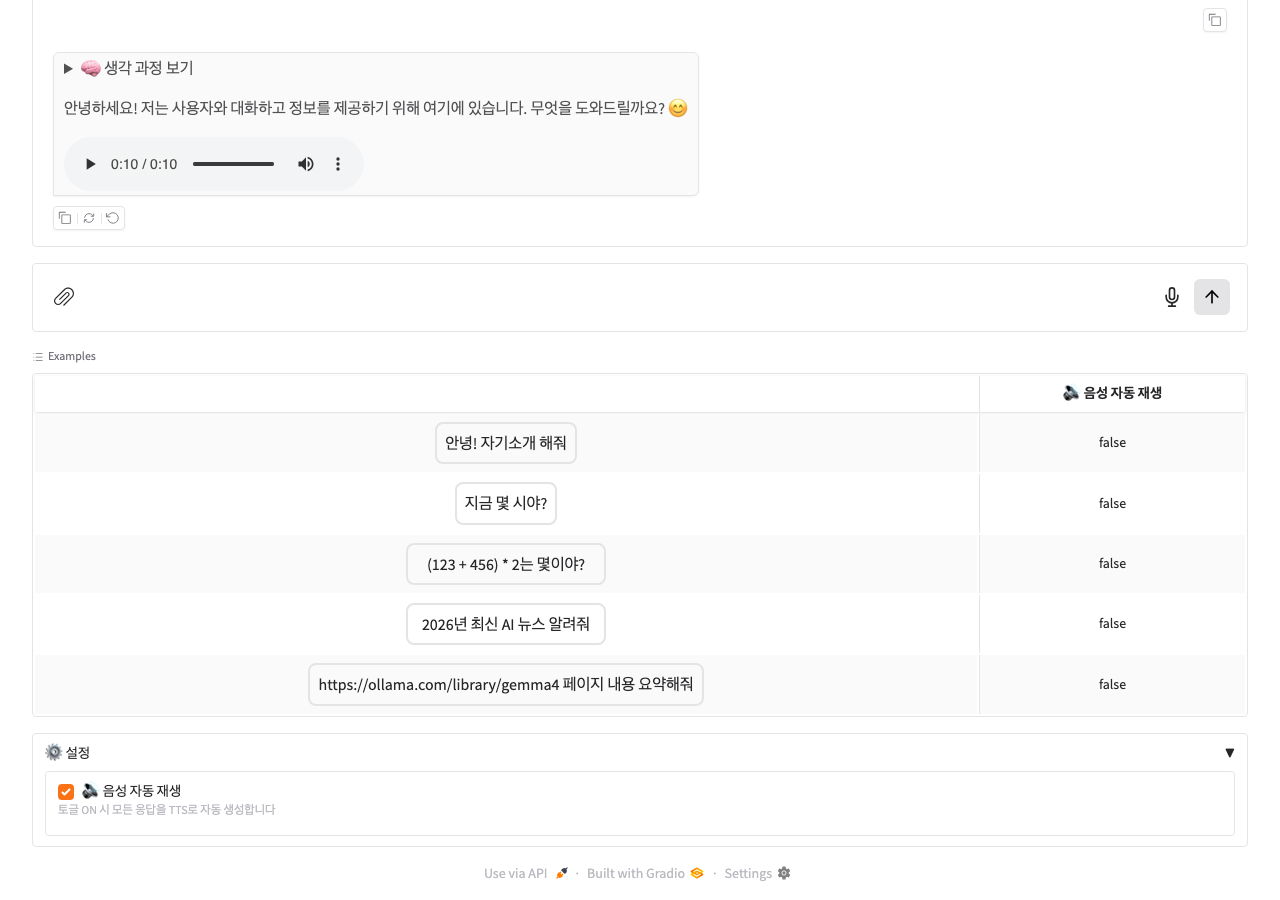
토글 ON 후 메시지를 보내면 응답 아래에 오디오 플레이어가 자동으로 생성된다. gTTS로 한국어 음성을 생성하고 <audio> 태그로 삽입한다. sanitize_html=False 설정으로 Gradio가 HTML을 렌더링하도록 했다.
6. 시연 영상
전체 기능을 순차적으로 테스트한 Playwright 자동화 영상이다. 도구 호출 과정과 응답 생성이 실시간으로 진행되는 것을 확인할 수 있다.
텍스트 도구 데모 (시간, 계산, 검색, URL)
멀티모달 데모 (이미지 분석, 음성 인식, TTS)
7. 핵심 기술 결정
왜 DuckDuckGo인가?
Tavily 등의 검색 API가 더 정교하지만, API 키가 필요 없고 로컬 개발 환경에서 바로 사용할 수 있다. 초소형 모델의 도구 호출 한계를 고려하면 검색 품질보다 “도구를 호출할 수 있는가”가 먼저다.
왜 수동 ReAct 루프인가?
LangGraph의 StateGraph가 더 견고하지만, 2.3B 모델의 도구 호출 성공률이 100%가 아니다. 디버깅이 쉽고 각 스텝을 세밀하게 제어할 수 있는 for 루프가 이 프로젝트에 더 적합했다.
왜 gr.ChatInterface인가?
gr.Blocks + Chatbot 조합으로 직접 빌드하는 것보다 멀티턴 대화가 자동 처리되고, multimodal=True 하나로 파일 업로드/마이크 입력이 활성화된다.
TTS 토글을 왜 추가했나?
기본적으로 TTS는 LLM이 text_to_speech 도구를 선택적으로 호출하는 방식이었다. 하지만 매번 “음성으로 변환해줘”라고 요청하는 것은 비효율적이다. 토글 ON 시 모든 응답에 자동으로 TTS 오디오를 생성하도록 개선했다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
# additional_inputs에 체크박스 추가
additional_inputs=[
    gr.Checkbox(value=False, label="🔊 음성 자동 재생",
                info="토글 ON 시 모든 응답을 TTS로 자동 생성합니다"),
],

# predict()에서 최종 답변 후 TTS 자동 생성
if tts_enabled:
    tts_filename = f"tts_{int(time.time() * 1000)}.mp3"
    tts = gTTS(text=final_answer, lang='ko')
    tts.save(os.path.join(TTS_DIR, tts_filename))
    audio_html = (
        f'<audio controls autoplay>'
        f'<source src="/file=tts_output/{tts_filename}" type="audio/mpeg">'
        f'</audio>'
    )
    result += audio_html
8. 알려진 한계
| 항목 | 내용 |
|---|---|
| 도구 호출 누락 | 2.3B 모델로 간헐적으로 도구를 호출하지 않음. 복잡한 질문은 여러 번 시도 필요 |
| 시간 도구 응답 | 도구를 호출하지만 결과를 최종 답변에 반영하지 않는 경우가 있음. System prompt 강화로 개선 |
| 음성 인식 | WAV만 직접 지원. MP3/OGG는 pydub 변환 필요. Gradio 마이크 녹음은 OGG 형식 |
| gTTS 의존성 | gTTS가 click<8.2를 요구하지만 다른 패키지와 충돌 가능 |
9. 실행 방법
1
2
3
4
5
6
7
8
9
10
11
# 1. Ollama로 모델 실행 (백그라운드)
ollama serve

# 2. 의존성 설치
pip install langchain langchain-ollama langchain-community \
  ddgs beautifulsoup4 requests gTTS Pillow \
  SpeechRecognition pydub gradio

# 3. 앱 실행
python app.py
# → http://localhost:7860 에서 접속
마치며
Gemma 4 E2B는 2.3B 파라미터라는 작은 크기에 비해 놀라운 성능을 보여준다. 특히 비전 기능과 도구 호출을 동시에 지원하는 것이 로컬 LLM의 가능성을 크게 넓혔다. API 키 없이, 인터넷 연결만 있으면 웹 검색부터 이미지 분석, 음성 인식까지 가능한 에이전트를 구축할 수 있다.
물론 아직 한계가 명확하다. 도구 호출이 누락되거나 결과를 제대로 반영하지 못하는 경우가 있다. 하지만 이는 모델 크기의 한계이며, 더 큰 Gemma 4 변형(12B, 27B)을 사용하면 개선될 수 있다.
로컬 LLM으로 할 수 있는 것의 범위가 빠르게 넓어지고 있다. 직접 해보면서 체감해보길 추천한다.