Spec-driven Development — AI가 바꾼 것과 바꾸지 못한 것 (Spring I/O 2026)
원본 영상: Spec-driven Development — Simon Martinelli @ Spring I/O 2026
TL;DR — 코드를 짜지 말고 유스케이스(명세)를 먼저 쓰세요. AI가 명세를 읽고 코드를 생성합니다. 기존 레거시 시스템은 AI가 코드에서 유스케이스를 역추출하고, 그걸로 새 앱을 만듭니다. 스프린트는 폐지하고 유스케이스 단위로 진행합니다. 결과: 현대화 프로젝트에서 신기능까지 자연스럽게 추가 가능.
왜 코드가 아닌 명세인가?
발표자 Simon Martinelli는 2024년, 스포츠 클럽 자원봉사 관리 시스템을 화이트 코딩 — 즉 “AI야 이거 만들어줘” 식으로 — 으로 시작했다. 초기에는 놀라운 속도로 기능이 만들어졌다. 그러나 기능을 하나둘 추가하다 보니, 어느 순간 코드가 너무 커졌고, 프로젝트 전체를 이해할 수 없는 상태에 이르렀다.
“내가 뭘 만들고 있는지 모르겠다.”
이 문제를 해결하기 위해 2024년 크리스마스쯤 Spec-driven Development를 발견했다. 그리고 이것이 화이트 코딩의 한계를 넘어서는 핵심 접근법이 되었다.
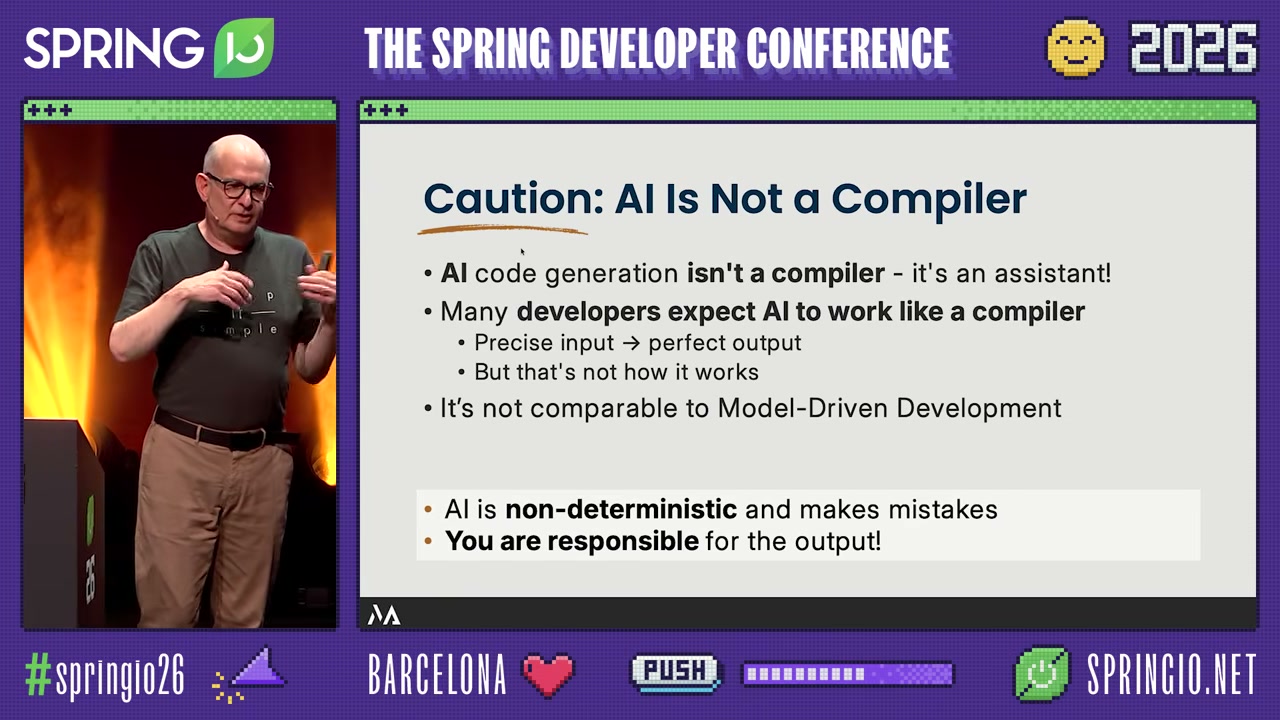
화이트 코딩이 실패하는 이유는 명확하다:
- AI에게 컨텍스트 없이 “만들어줘”라고 하면, AI는 그 순간의 프롬프트만 보고 코드를 생성한다
- 기능이 누적될수록 전체 시스템의 일관성이 무너진다
- 누가 어떤 결정을 왜 내렸는지 추적할 수 없다
- 결국 “작동하는데 뭔지 모르는 코드”가 산더미처럼 쌓인다
Thomas Schilling이 전날 세션에서 말했던 것과 정확히 같은教训이다. 해결책은 같은 곳을 가리키고 있다 — 명세(Spec).
Spec-driven Development란?
Spec-driven Development는 AI 기반 소프트웨어 개발 방법론으로, 세 가지 핵심 기둥 위에 서 있다.
3대 기둥
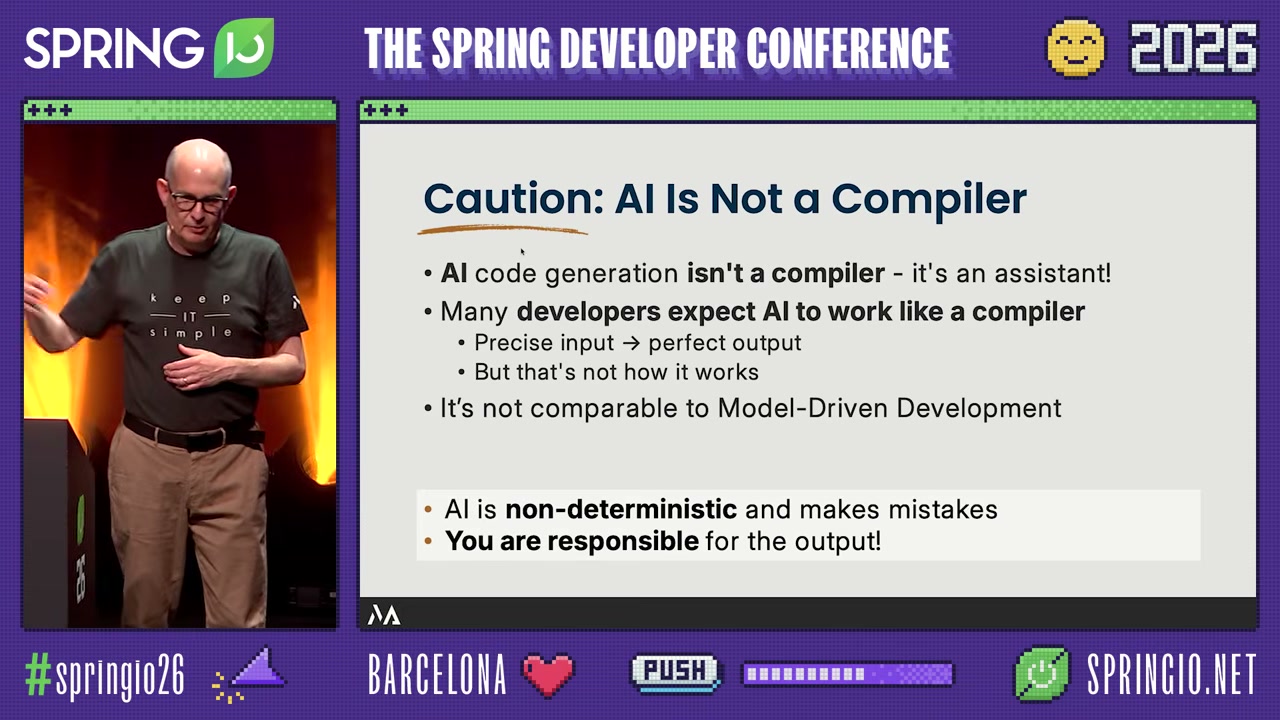
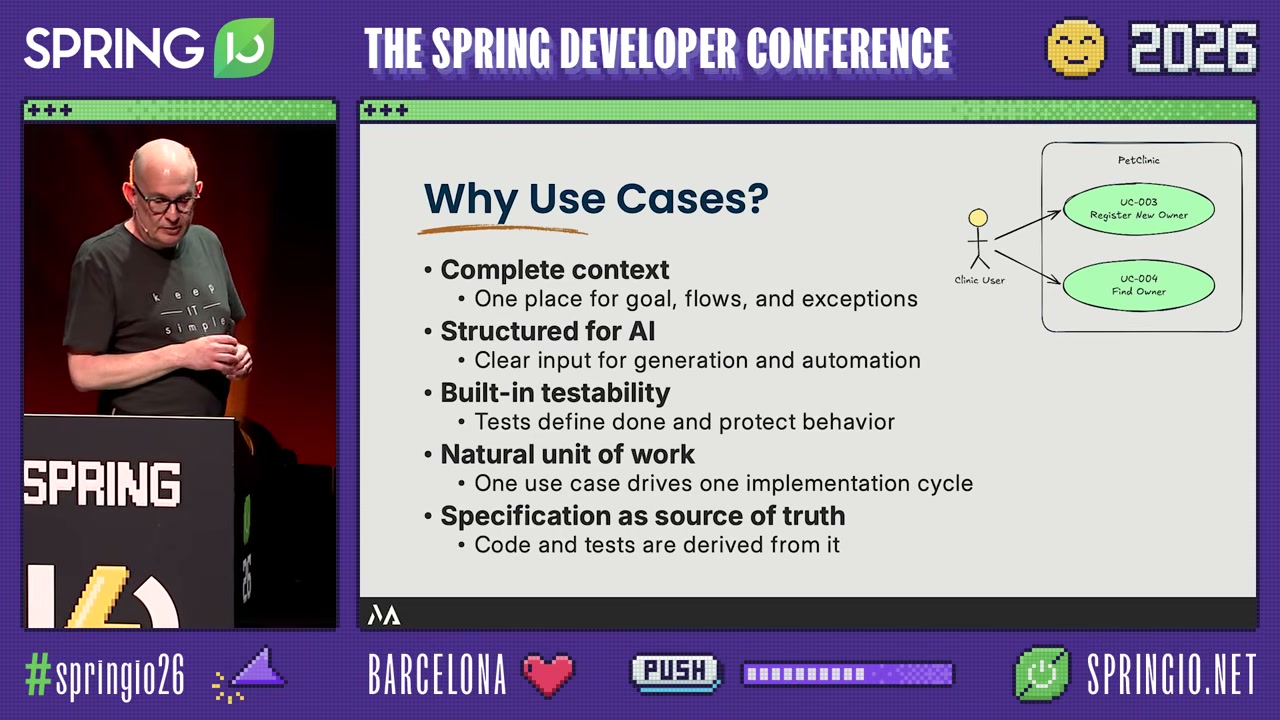
1. Spec-centric — 명세가 소스 오브 트루스
코드가 아니라 유스케이스 명세가 진리의 원천이다. AI는 명세를 읽고 코드를 생성하며, 모든 구현은 명세에 대해 검증된다. 코드가 변경되면 명세가 아닌 구현이 틀린 것이다.
2. Context-aware — AI가 충분한 컨텍스트 보유
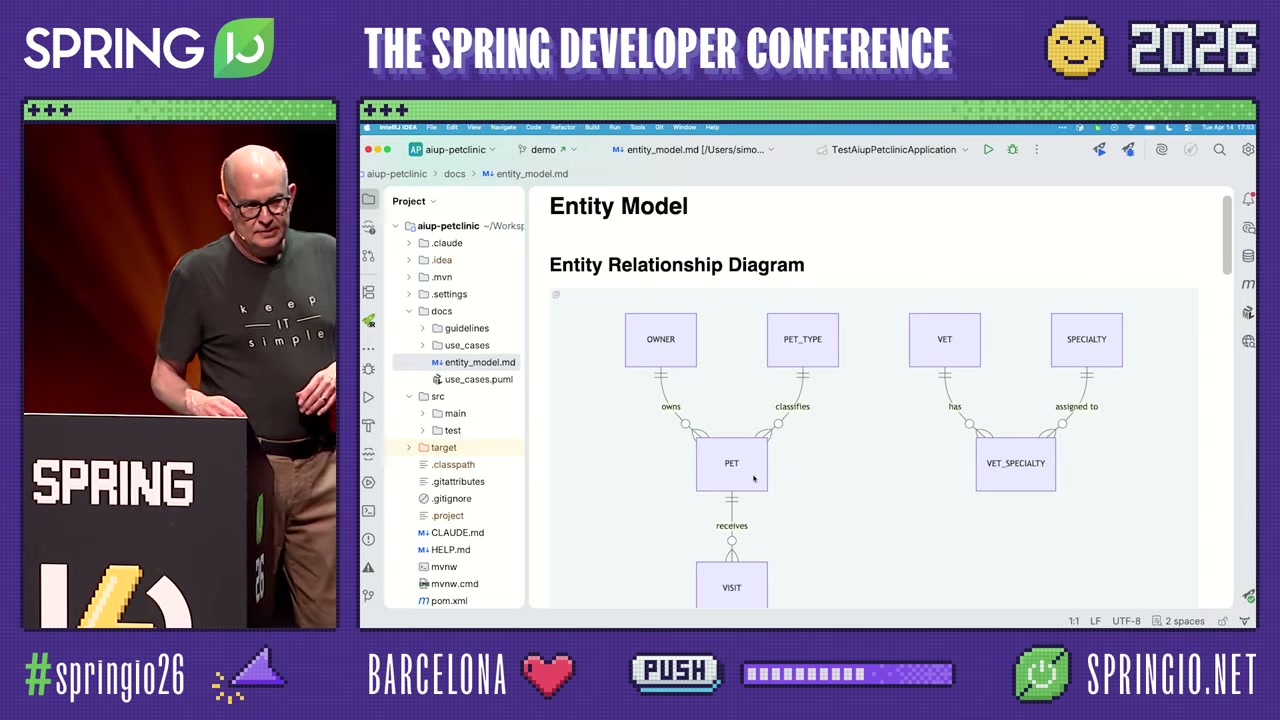
AI가 제대로 된 코드를 만들려면 충분한 컨텍스트가 필요하다. 이것은 단순히 “프로젝트 설명”이 아니라, 도메인 모델, 아키텍처 결정, 기술 스택, 코딩 컨벤션 등 프로젝트 전체를 아우르는 정보다.
3. Agent Experience — 개발자 친화적 도구
AI가 아니라 개발자가 중심이다. Claude Code의 Skills, MCP 서버, 커스텀 스킬 등 도구는 개발자의 워크플로우에 맞춰져야 한다. AI가 도구를 사용하는 것이 아니라, 도구가 AI를 관리한다.
Model-Driven Development(MDD)와의 차이
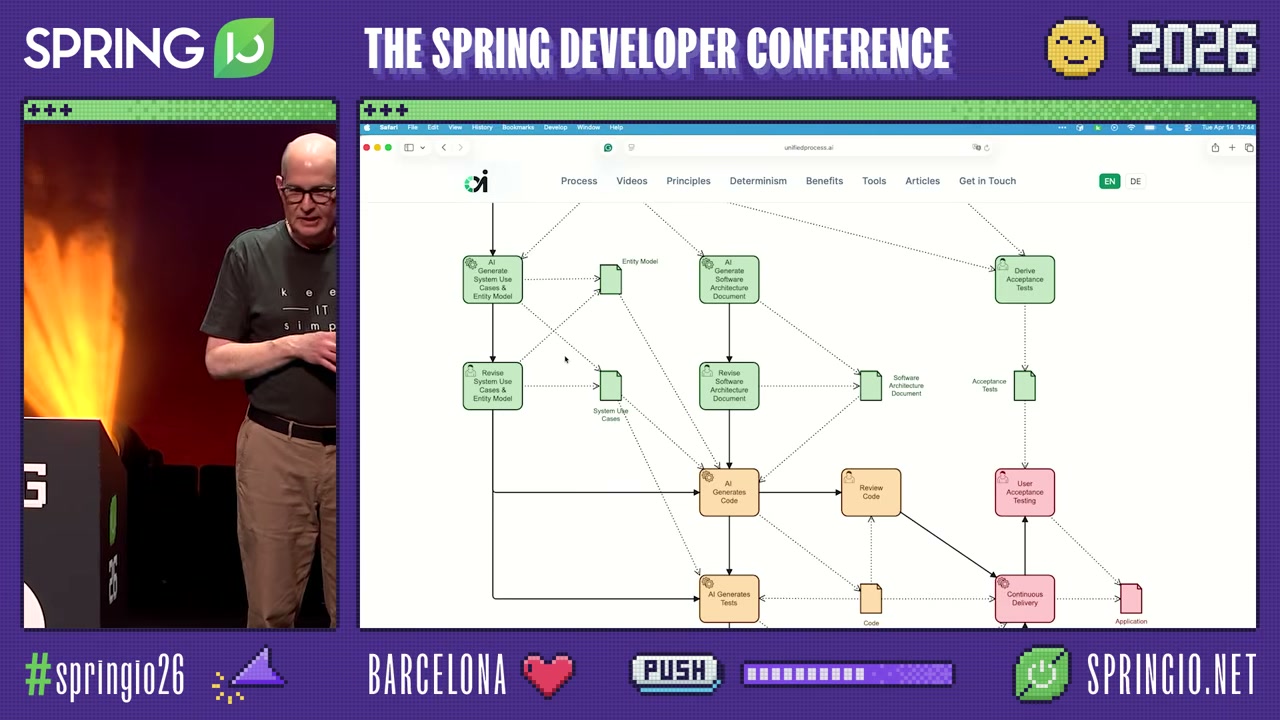
“또 모델 기반 개발인가?”라는 질문이 나올 수 있다. Simon은 명확히 구분한다:
| 측면 | MDD | Spec-driven Development |
|---|---|---|
| 결정론성 | 모델에서 항상 같은 코드 생성 | AI는 비결정론적 — 매번 다른 코드 가능 |
| 검증 | 모델과 코드의 1:1 일치 | 테스트 통과면 OK |
| 유연성 | 템플릿에 종속 | 프리텍스트에 따라 최적의 구현 선택 |
| 비유 | 조립 라인 | 두 개발자에게 같은 과제를 준 것 |
“두 개발자에게 같은 과제를 주면 코드는 다르지만 결과는 같은 것” — Spec-driven Development는 이것을 AI에게 허용한다.
핵심 차이는 결과가 아니라 과정에 있다. MDD는 결정론적이라 모든 엣지 케이스를 모델에 정의해야 한다. Spec-driven Development는 AI가 비결정론적으로 코드를 작성하되, 유스케이스 테스트가 통과하면 그 구현을 인정한다. 이것이 훨씬 현실적이고 확장 가능한 접근법이다.
AI Unify Process — 실무 프로세스
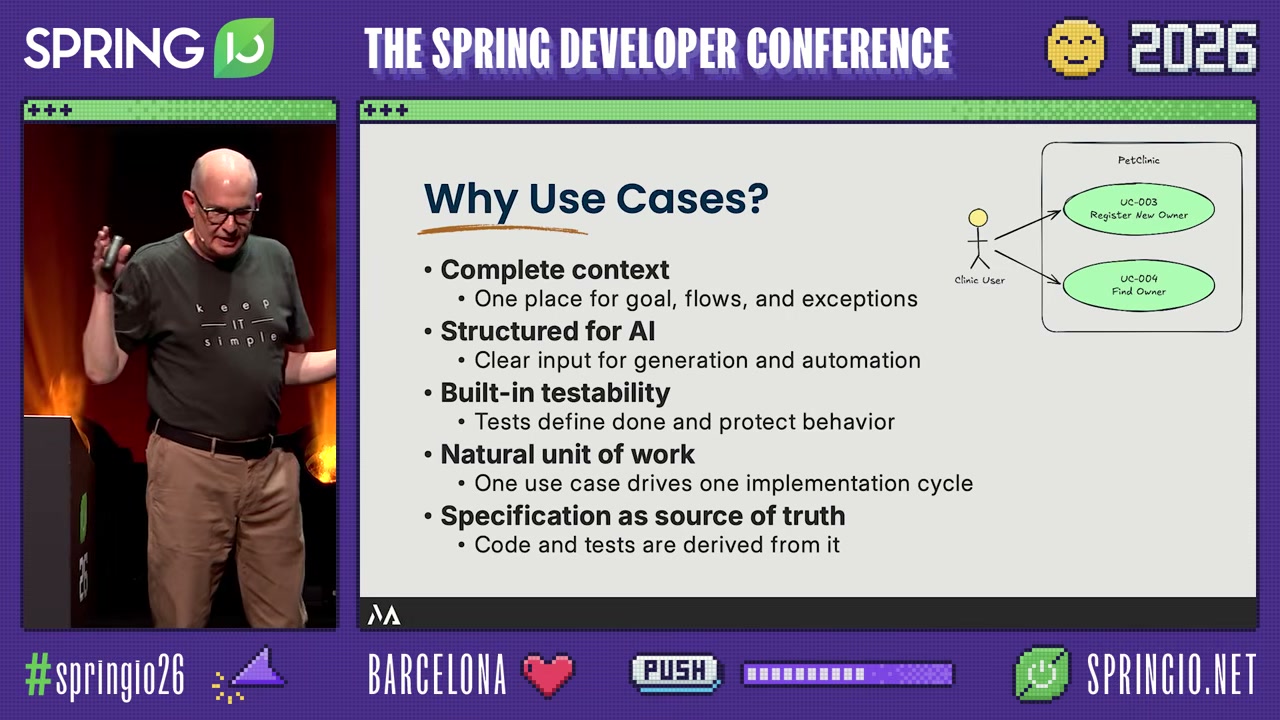
Simon이 소개하는 AI Unify Process는 Greenfield와 Brownfield 두 가지 워크플로우로 나뉜다.
Greenfield 워크플로우
새로운 프로젝트를 만들 때의 흐름:
1
2
3
4
5
요구사항 엔지니어/PO가 유스케이스 + 도메인 모델 작성
    → AI가 명세 리뷰 (완전성, 일관성 검증)
    → 코드 + 테스트 생성
    → 개발자 검증 (리뷰 + 수동 테스트)
    → 병합
이 워크플로우의 핵심은 명세 작성이 AI 코딩보다 먼저라는 점이다. Thomas Schilling의 Interview 스킬과 유사한 접근이지만, Spec-driven Development는 더 포말한 유스케이스 템플릿을 사용한다.
Brownfield 워크플로우 (★ 핵심)
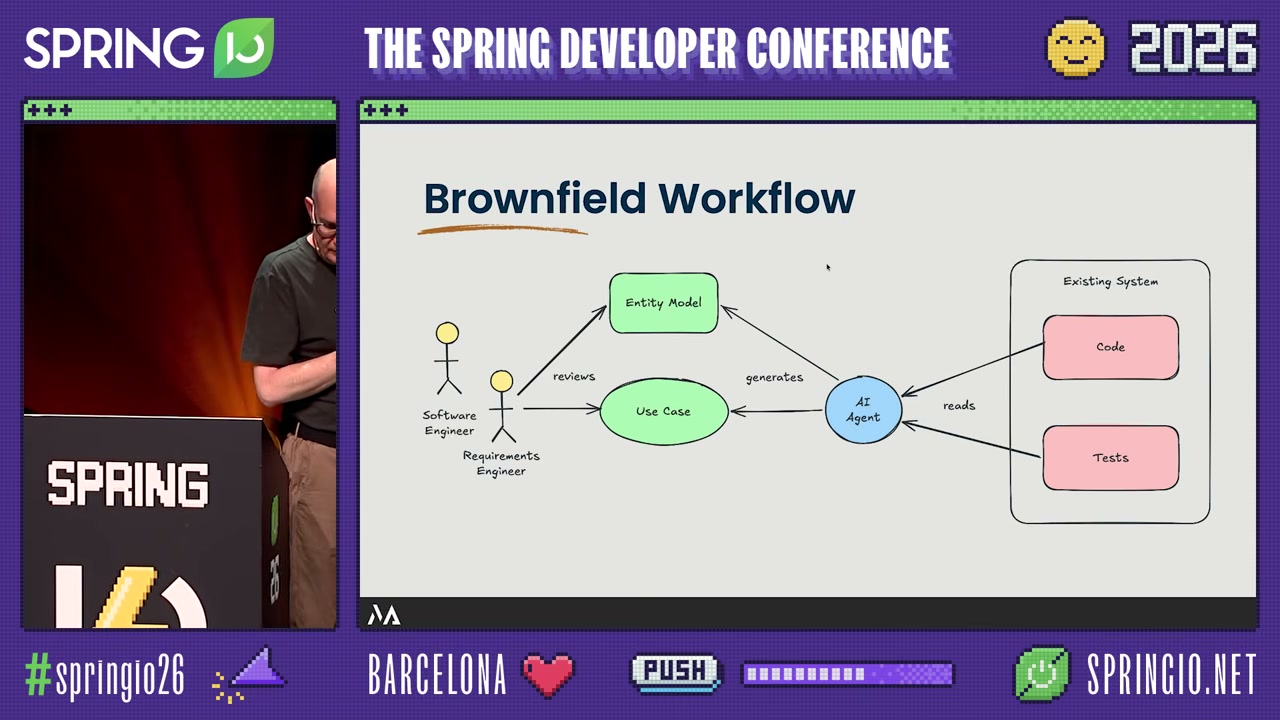
이 발표의 하이라이트는 기존 시스템 현대화 워크플로우다:
1
2
3
4
기존 코드 + Jira 티켓 + Confluence 문서
    → AI가 유스케이스 역추출 (Reverse Engineering)
    → 추출된 유스케이스 검증 + 보완
    → 새 앱으로 재생성
이것이 단순한 COBOL→Java 1:1 변환이 아니라 사양 역추출 후 재구현이라는 점이 혁신적이다:
- “기존 기능만 그대로 옮겨라” 제약이 사라짐 — 사양에 새 기능을 추가하면 AI가 그것도 구현한다
- 현대화 프로젝트에서 사용자가 10년간 기다리던 신기능을 드디어 추가할 수 있다
- 레거시 코드의 버그나 누락된 기능도 사양으로 역추출되면서 자연스럽게 발견된다
“우리가 정부 프로젝트에서 레거시 시스템의 버그와 누락 기능을 사양으로 역추출하는 동안, 고객은 ‘이 기능 우리가 원래 원했던 건데!’라고 반응했다.”
실제 프로젝트 사례
사례 1: 스위스 정부 프로젝트
기존 정부 시스템의 현대화 프로젝트. AI가 레거시 코드에서 유스케이스를 역추출하는 방식으로 진행 중.
팀 구성:
- RE(Requirements Engineering) 엔지니어 2명 — 주 5일 풀타임
- 개발자 1명 — 주 1일만 참여
이 구성만으로도 프로젝트가 진행 가능하다는 점이 인상적이다. RE 엔지니어가 유스케이스를 작성/검증하고, AI가 코드를 생성하며, 개발자는 주 1일 리뷰만 담당한다. 전통적인 방식이라면 상상할 수 없는 팀 구성이다.
사례 2: 스위스 최대 도매업체
규모:
- 1,000개 이상의 DB 테이블을 가진 거대 ERP 시스템
- 기존: Eclipse RCP + JBoss
- 대상: Spring Boot + Vaadin
이 정도 규모의 시스템을 현대화하는 것은 전통적으로 수년이 걸리는 프로젝트다. 하지만 AI Unify Process를 통해 유스케이스 단위로 점진적 현대화가 가능해졌다.
유스케이스 구조
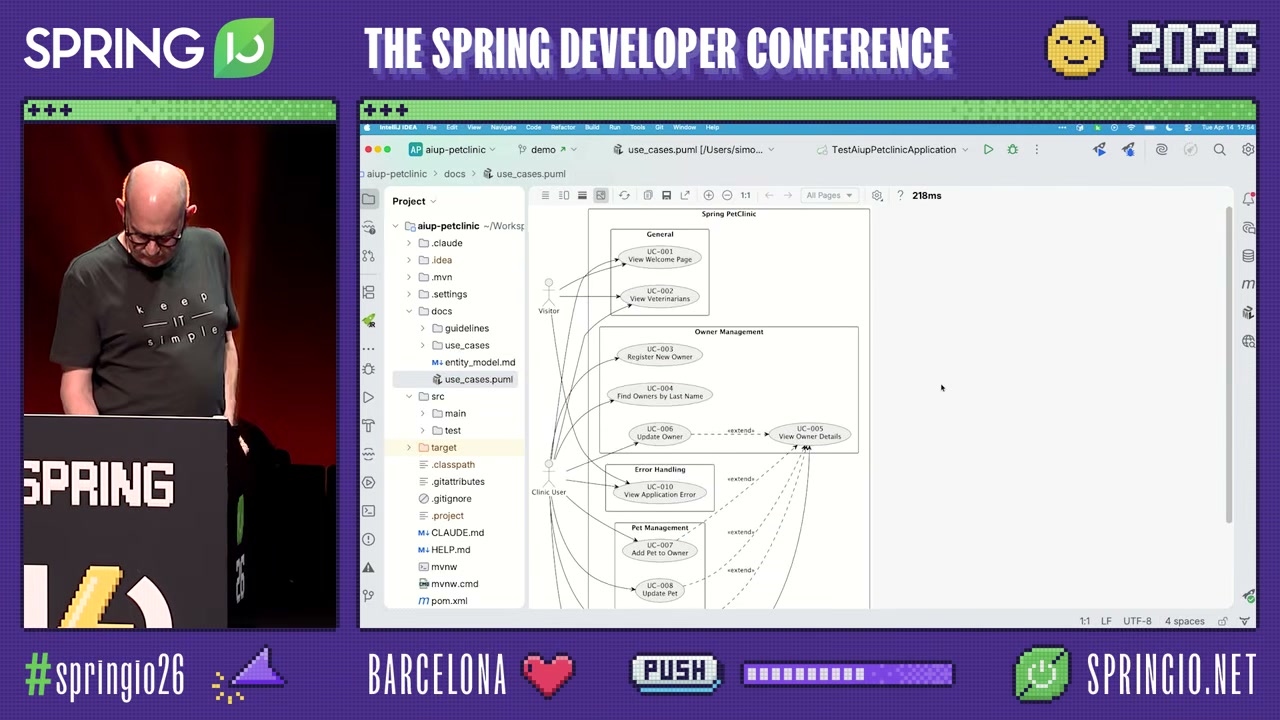
Spec-driven Development에서 사용하는 유스케이스는 Ivar Jacobson 템플릿을 기반으로 한다. 이것은 소프트웨어 엔지니어링에서 오랜 역사를 가진 검증된 형식이다:
유스케이스 필수 요소
- Actor — 시스템과 상호작용하는 역할
- Goal — 이 유스케이스가 달성하려는 목표
- Preconditions — 시작 전 충족되어야 하는 조건
- Main Success Scenario — 정상 흐름의 단계별 설명
- Alternative Flows — 대안 경로
- Error Flows — 예외 처리
- Post-conditions — 완료 후 시스템 상태
- Business Rules — 적용되는 비즈니스 규칙
유스케이스 작성의 실전 팁
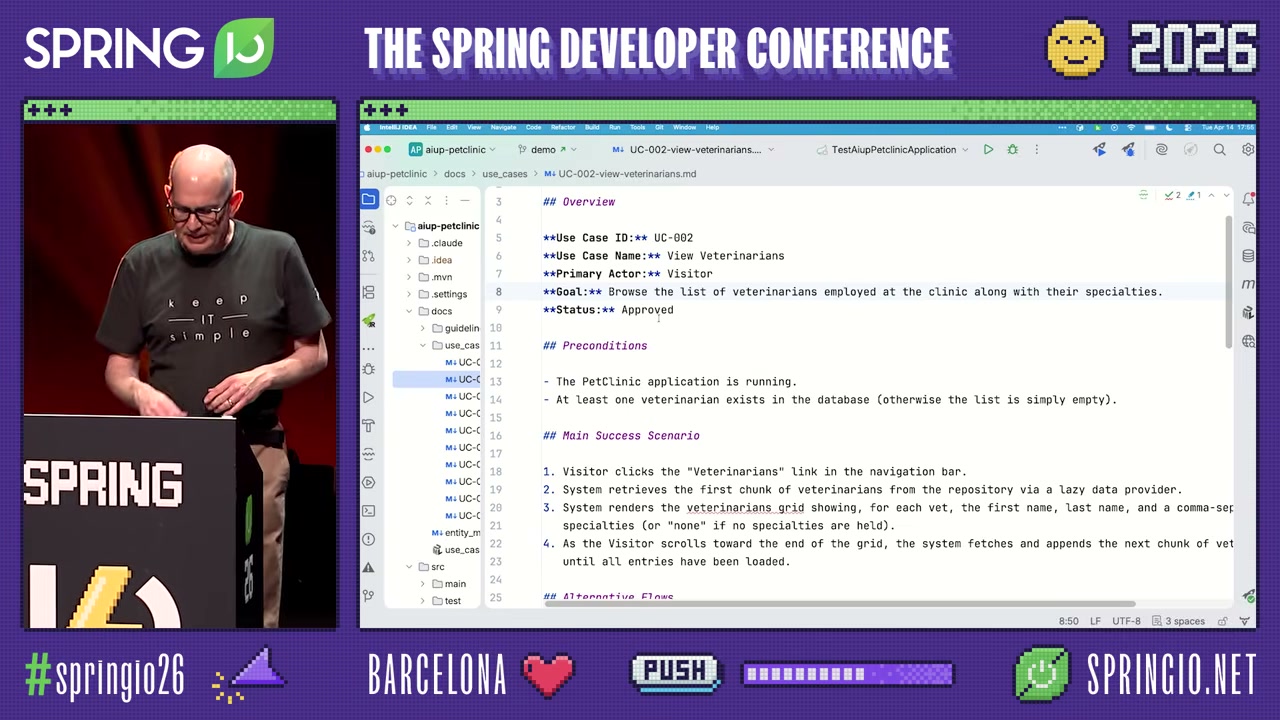
유스케이스를 처음 작성할 때 어디서부터 시작해야 할지 막막할 수 있다. Simon은 다음과 같은 접근법을 추천한다:
1. Actor부터 시작하라 — 누가 시스템을 사용하는가? 관리자, 일반 사용자, 시스템(배치 등) 등 역할을 명확히 정의한다.
2. Goal을 한 문장으로 작성하라 — “사용자가 X를 하면 Y가 된다” 형태로 유스케이스의 목적을 명확히 한다.
3. Happy path를 먼저 완성하라 — Main Success Scenario만 먼저 작성하고, 그다음 Alternative와 Error flows를 추가한다.
4. Business Rules를 명시하라 — “금액은 음수가 될 수 없다”, “관리자 승인이 필요하다” 같은 규칙을 유스케이스에 명시하면 AI가 이를 코드에 반영한다.
실전에서의 유스케이스
실전에서는 Word 문서 26페이지 분량의 유스케이스도 있다. 이 정도 되면 엔지니어뿐 아니라 비즈니스 사용자도 읽고 검증할 수 있는 수준이다.
이것이 Spec-driven Development의 숨겨진 장점이다. 유스케이스가 자연어로 작성되어 있기 때문에:
- 비즈니스 사용자가 직접 요구사항을 검증할 수 있다
- 개발자와 비개발자 간의 의사소통 갭이 줄어든다
- AI가 읽을 수 있고 사람도 읽을 수 있는 공통 언어가 된다
Claude Code Skills + MCP
Spec-driven Development의 실제 구현은 Claude Code의 기능 위에서 이루어진다.
Skills 활용
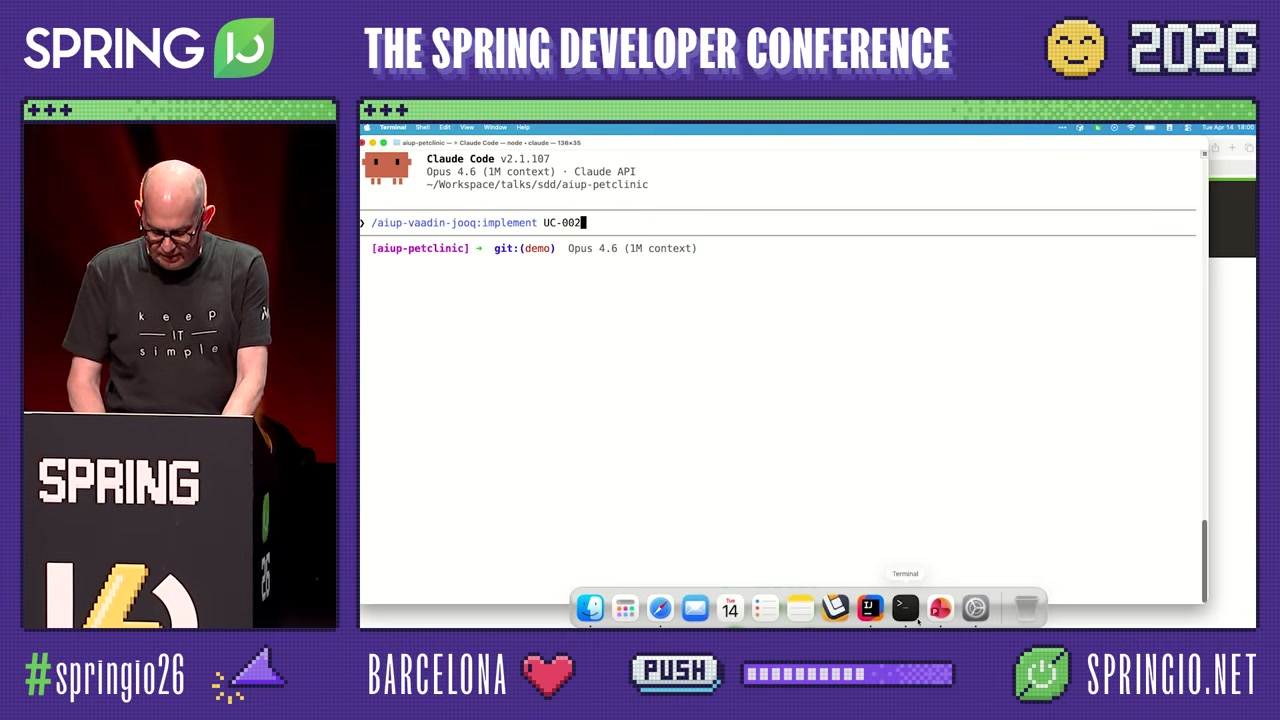
Thomas Schilling의 세션에서도 강조되었지만, Claude Code Skills은 Spec-driven Development의 핵심 인프라다.
실제 사용 예:
1
/implement use-case-002
프롬프트 없이 스킬을 직접 호출하면, AI가 해당 유스케이스를 읽고 코드를 생성한다. 이것은 프롬프트 작성 시간을 없애고, 일관된 구현 품질을 보장한다.
스킬 프론트매터의 역할:
Skills에 프론트매터를 달면 AI가 자동으로 언제 사용할지 판단한다:
1
2
3
4
5
6
---
name: implement-usecase
description: Generate implementation from a use case specification
globs:
  - "specs/use-cases/*.md"
---
이렇게 하면 AI가 유스케이스 파일을 수정할 때 자동으로 구현 스킬을 트리거한다.
커스텀 스킬 생태계:
- 프로젝트별 커스텀 스킬 작성 가능
- 회사 레벨에서 공유되는 표준 스킬
- GitHub 마켓플레이스를 통한 커뮤니티 공유
⚠️ 주의: 검증되지 않은 스킬은 프롬프트 인젝션 위험이 있다. jvmskills.com처럼 전문가가 리뷰한 스킬만 사용하는 것이 안전하다.
MCP 서버
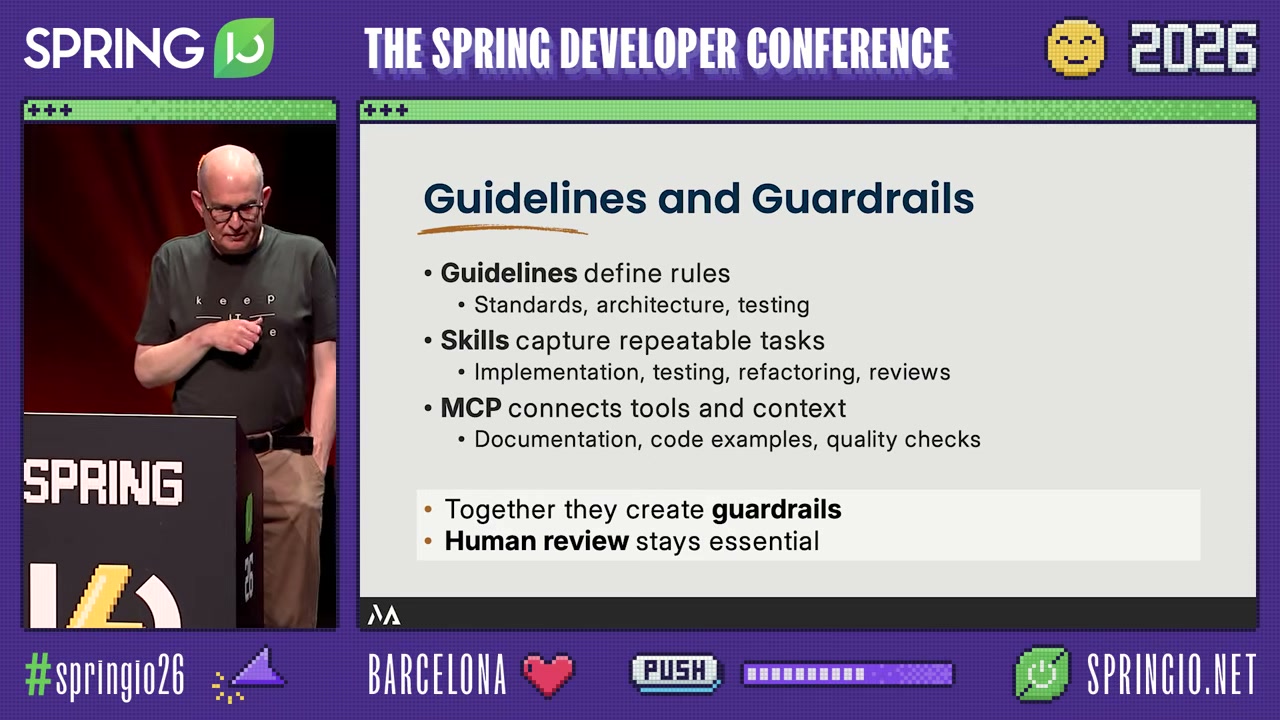
MCP(Model Context Protocol) 서버는 AI의 컨텍스트를 풍부하게 만드는 핵심 도구다. Simon이 실제 프로젝트에서 사용하는 MCP 서버들:
| MCP 서버 | 역할 |
|---|---|
| JavaDoc MCP | API 문서를 벡터 검색으로 조회 — AI가 최신 API를 정확히 사용 |
| Figma MCP | UI 디자인을 직접 읽고 구현 — 디자이너-개발자 갭 해소 |
| Vaadin MCP | Vaadin 컴포넌트에 대한 컨텍스트 제공 |
| Karibu Testing MCP | Vaadin 테스트 프레임워크 지원 |
Thomas Schilling이 IntelliJ MCP를 강조했다면, Simon은 JavaDoc MCP와 Figma MCP를 특히 강조한다. 이것은 Spec-driven Development가 UI까지 포함한 풀스택 접근법임을 보여준다.
테스트 전략
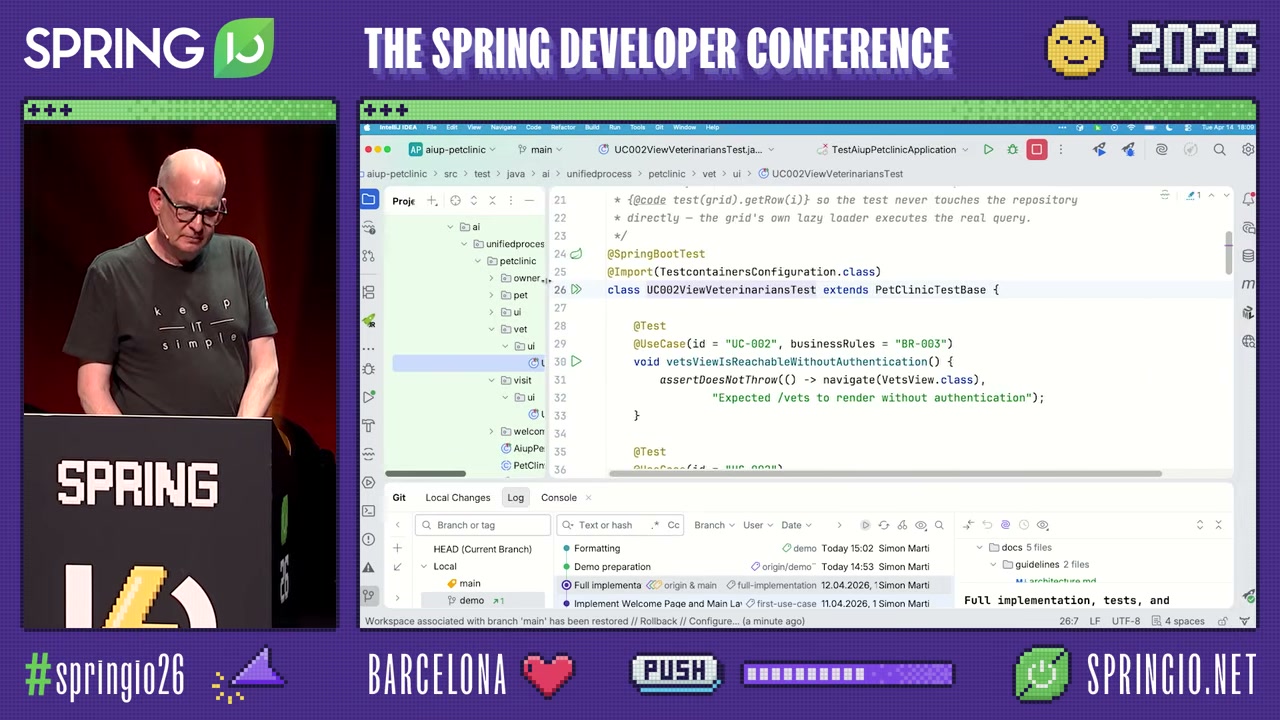
명세 기반 개발에서 테스트는 명세와 구현 사이의 계약이다. Simon은 두 가지 테스트 전략을 소개한다:
| 테스트 | 방식 | 목적 |
|---|---|---|
| White box | 유스케이스별 browserless 테스트 | 명세-구현 일치 검증 |
| Black box | Playwright E2E | 실제 사용자 워크플로우 검증 |
White box 테스트 — 유스케이스 검증
각 유스케이스에 대해 browserless 테스트를 작성한다. 이 테스트는 유스케이스의 Main Success Scenario, Alternative Flows, Error Flows를 모두 커버한다.
테스트가 통과하면 해당 유스케이스가 명세대로 구현되었음이 보장된다. 코드가 어떻게 작성되었든 상관없다.
Black box 테스트 — 사용자 경험 검증
Playwright E2E 테스트로 실제 사용자 워크플로우를 검증한다. 이것은 개별 유스케이스가 아니라 유스케이스 간의 통합과 실제 UI 동작을 확인한다.
드리프트 관리
시간이 지나면서 명세와 구현 사이에 드리프트가 발생할 수 있다. Simon은 유스케이스 ID와 비즈니스 룰 매핑 어노테이션으로 이를 관리한다:
1
2
3
4
@UseCase(id = "UC-002", rule = "BR-015")
public void processVolunteerRegistration(...) {
    // ...
}
이 어노테이션을 통해 어떤 비즈니스 룰이 어떤 코드에서 구현되었는지 추적 가능하다. 룰이 변경되면 영향받는 코드를 즉시 파악할 수 있다.
브라운필드에서의 테스트
새 앱을 구현할 때 레거시 시스템의 동작을 기준으로 테스트를 작성하는 것이 핵심이다. 레거시의 의도된 동작(버그 포함)을 테스트로 캡처한 후, 새 앱이 이를 통과하면 기능적 동등성이 보장된다.
이때 유스케이스 역추출 과정에서 발견된 버그 사항은 테스트에서 제외하고, 올바른 동작으로 테스트를 작성한다. 즉, 레거시를 있는 그대로 복제하는 것이 아니라 올바른 사양으로 재구현하는 것이다.
아키텍처가 AI 개발에 미치는 영향
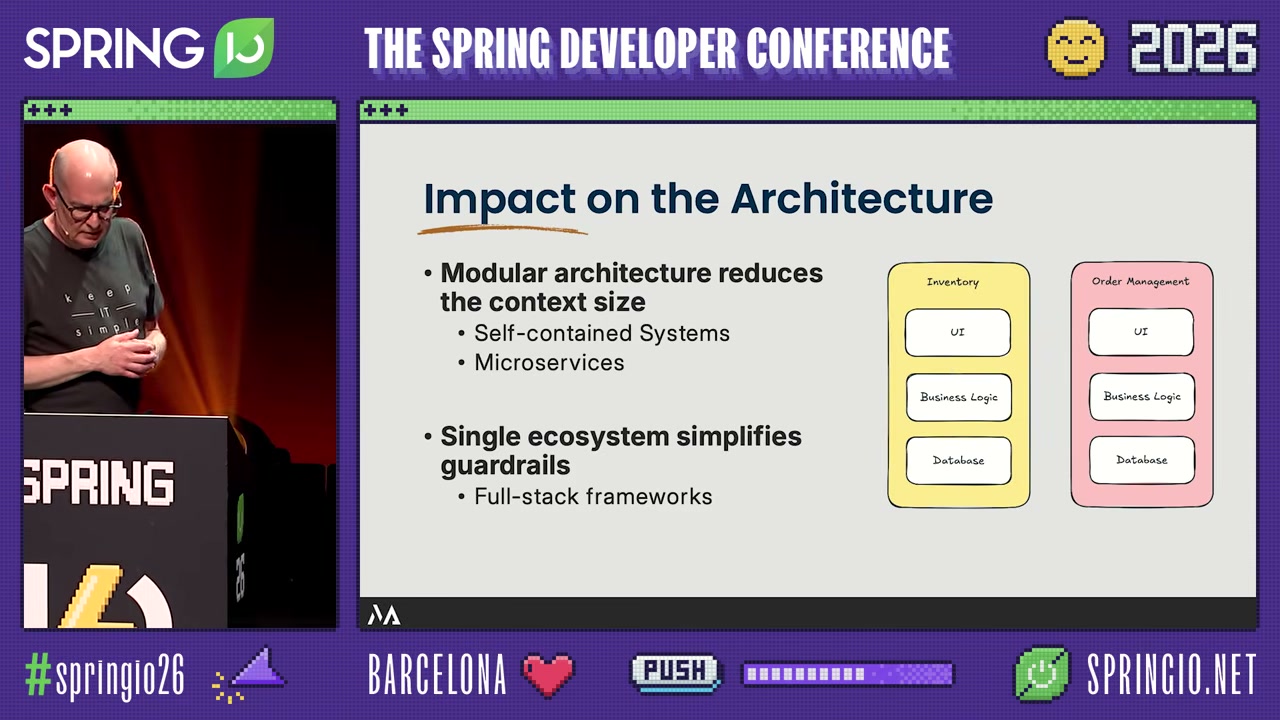
이 발표에서 가장 실무적인 통찰은 아키텍처 선택이 AI 개발의 성패를 가른다는 것이다.
컨텍스트 축소가 핵심
AI에게 프로젝트 전체를 주면 컨텍스트 과부하가 발생한다. 1,000개 테이블의 ERP를 한 번에 처리하라고 하면, AI는 필연적으로 중요한 것을 놓친다.
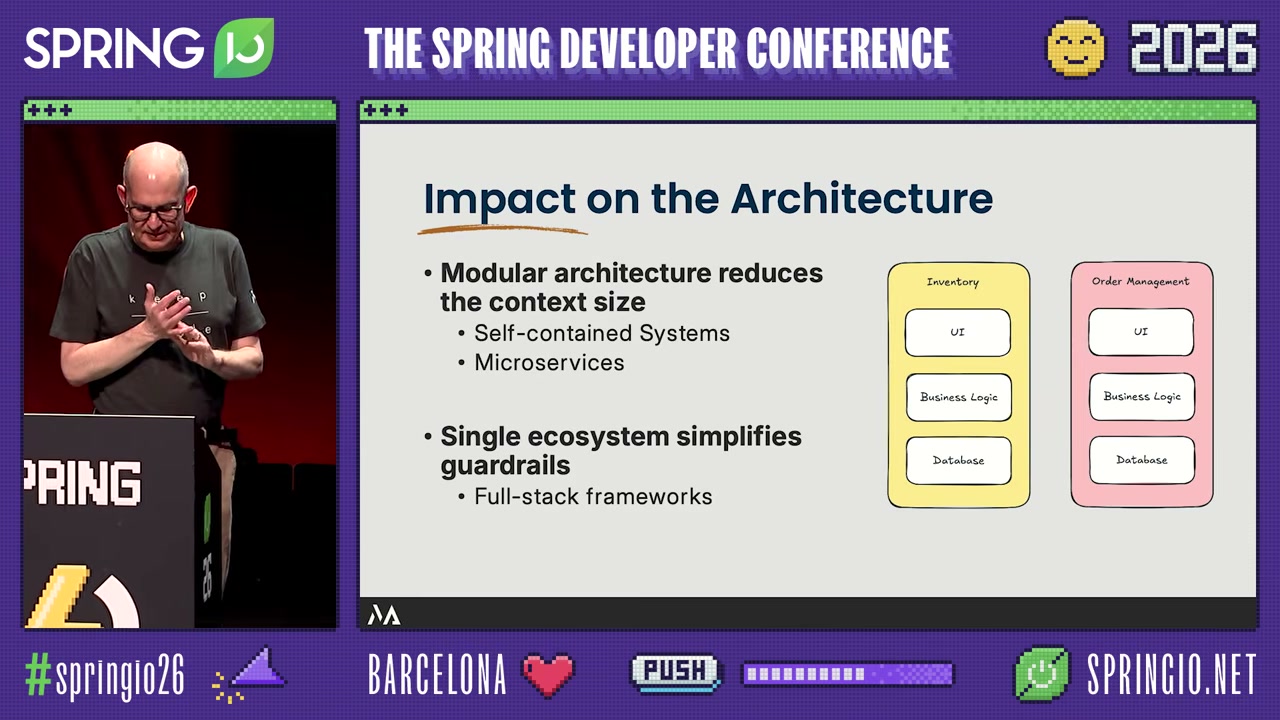
Self-contained System이 해결책이다:
1
2
3
4
5
6
┌─────────────────┐  ┌─────────────────┐  ┌─────────────────┐
│   UI (Vaadin)   │  │   UI (Vaadin)   │  │   UI (Vaadin)   │
│  Business Logic │  │  Business Logic │  │  Business Logic │
│  Local Database │  │  Local Database │  │  Local Database │
└─────────────────┘  └─────────────────┘  └─────────────────┘
   System A             System B             System C
각 시스템이 UI + 비즈니스 로직 + DB를 수직으로 슬라이스하여 독립적으로 동작한다. AI가 하나의 시스템에 집중할 때, 필요한 컨텍스트가 그 시스템 안에 모두 있다.
풀스택 프레임워크가 유리한 이유
Vaadin, Thymeleaf, Next.js 같은 풀스택 프레임워크는 AI 개발에 특히 유리하다:
- 가드레일이 한 세트만 필요 — 프론트엔드/백엔드를 따로 관리할 필요 없음
- 한 개의 에이전트가 유스케이스를 끝到끝 구현 가능
- Claude Code Skills을 하나의 프레임워크에만 맞추면 됨
반면, Angular + Spring REST처럼 프론트/백이 분리된 구조는:
- 두 개의 생태계에 각각 가드레일을 설정해야 한다
- 유스케이스 구현 시 두 시스템을 동시에 수정해야 한다
- 컨텍스트가 분산되어 AI의 효율이 떨어진다
Modular Monolith이 AI 개발에 최적
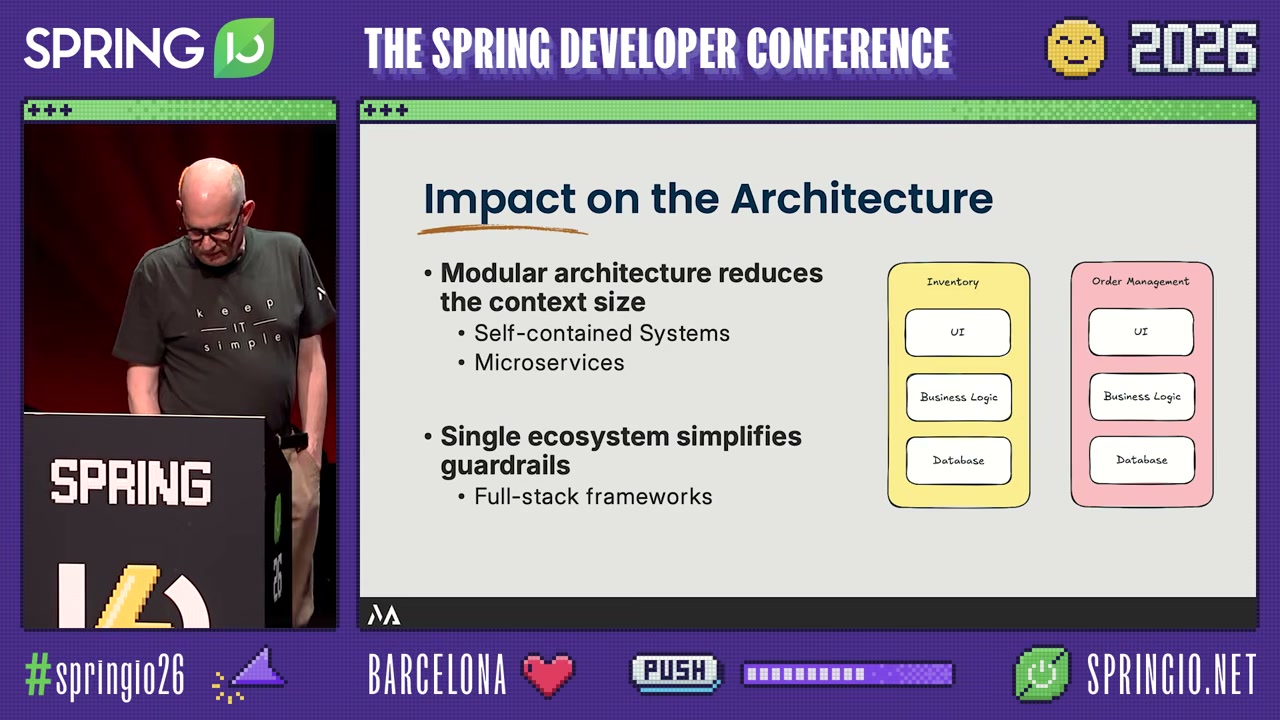
Simon의 결론은 명확하다:
Modular Monolith가 AI 기반 개발에 최적의 아키텍처다.
이유:
- 모듈별로 독립된 컨텍스트 — AI가 한 모듈에 집중 가능
- 풀스택 프레임워크와 자연스럽게 결합
- 마이크로서비스의 분산 복잡도 없이 모듈성 확보
- 필요하면 나중에 마이크로서비스로 분리 가능 (최적화 전에 먼저 측정하라)
마이크로서비스의 딜레마
마이크로서비스 아키텍처에서 AI가 유스케이스를 구현하려면, 관련된 모든 서비스의 코드를 로컬에 가져와야 한다. 그렇지 않으면 AI가 API를 추측하거나 문서에 의존해야 한다.
해결책 두 가지:
- Mono-repo — 모든 서비스 코드가 하나의 저장소에
- 완벽한 OpenAPI 문서 — 모든 엔드포인트가 문서화되어 있어야 함
현실에서는 두 가지 모두 제대로 되어 있는 경우가 드물다. 그래서 Simon은 Modular Monolith를 추천하는 것이다.
프로젝트 관리의 변화
Spec-driven Development는 소프트웨어 개발 방법론뿐 아니라 프로젝트 관리 방식도 근본적으로 바꾼다.
스프린트 폐지
전통적인 애자일의 스프린트(Sprint) 개념을 폐지하고, 유스케이스 단위(compound flow)로 전환한다:
| 전통적 애자일 | Spec-driven Development |
|---|---|
| 2주 스프린트 | 유스케이스 단위 진행 |
| 스토리 포인트 | 유스케이스 복잡도 |
| 스프린트 플래닝 | 유스케이스 우선순위 결정 |
| 데일리 스탠드업 | 유스케이스 진행 상태 확인 |
이것은 자연스러운 전환이다. 이미 유스케이스가 명세의 단위이고, AI가 유스케이스 단위로 구현하므로, 프로젝트 관리도 동일한 단위를 따르는 것이 합리적이다.
인력 구성의 변화
정부 프로젝트 사례에서 본 것처럼:
- RE 엔지니어 2명(풀타임) + 개발자 1명(주 1일)로도 프로젝트 가능
- AI가 코드를 생성하므로, 개발자의 역할이 리뷰어 + 아키텍트로 변화
- 요구사항 엔지니어의 중요성이 대폭 증가
현대화 프로젝트의 패러다임 전환
전통적인 현대화 프로젝트의 가장 큰 문제는 “기존 기능만 그대로 옮기는” 제약이었다. 사용자는 5년, 10년간 기다려온 신기능을 원하지만, 프로젝트 범위가 “기존 기능 유지”로 제한되면 결코 추가할 수 없었다.
Spec-driven Development는 이 제약을 완전히 해제한다:
- 사양에 새 기능을 추가하면 AI가 기존 기능과 함께 구현한다
- 현대화와 신기능 개발이 하나의 프로젝트로 통합된다
- 사용자 만족도가 극적으로 상승한다 — 마침내 기다리던 기능이 온다
복합 플로우(Compound Flow)
유스케이스 단위 진행에서 더 나아가, 관련된 유스케이스를 그룹화하여 하나의 “compound flow”로 관리한다. 예를 들어 “사용자 가입” 유스케이스와 “이메일 인증” 유스케이스는 연관되어 있으므로 하나의 flow로 묶어서 진행한다.
이것은 스프린트와 달리 비즈니스 가치 기반으로 그룹화한다. 개발 편의성이나 기술적 분류가 아니라, 사용자에게 제공되는 가치 단위로 작업을 조직한다.
핵심 인사이트
이 발표에서 얻을 수 있는 5가지 핵심 인사이트를 정리한다.
1. 명세 = AI의 가이드레일
비결정론적 AI에게 방향성을 부여하는 것이 명세다. 명세 없이 AI에게 코드를 짜라고 하면, AI는 그 순간의 프롬프트만 보고 결정을 내린다. 명세가 있으면 AI는 비즈니스 목표를 이해하고 그에 맞는 코드를 생성한다.
2. 지속가능성 — 10년 후에도 재생성 가능
명세가 진리의 원천이므로, 10년 후에 다른 기술 스택으로 전환하더라도 동일한 명세로 재생성할 수 있다. 코드는 기술 스택에 종속되지만, 명세는 그렇지 않다. 이것이 장기적인 자산 가치를 보장한다.
3. 리뷰는 필수
모르는 기술 스택으로 AI가 코딩하면 “작동하는데 뭔지 모르는 코드”를 생산하게 된다. Thomas Schilling도 같은 경고를 했다 — AI가 코드를 만들어도, 엔지니어는 각 결정을 이해해야 한다.
4. 도메인 지식은 AI의 것이 아니다
AI는 코딩을 잘하지만, 비즈니스 도메인을 이해하지 못한다. 아키텍처 결정, 비즈니스 룰 정의, 우선순위 결정은 여전히 사람의 몫이다. Spec-driven Development는 이를 명확히 분리한다 — 사람은 명세를 쓰고, AI는 코드를 짠다.
5. 현대화 프로젝트의 패러다임 전환
“기능 옮기기”에서 “사양 재정의 + 구현”으로의 전환이다. 이것은 현대화 프로젝트의 가장 큰 병목이었던 범위 고착화 문제를 해결한다. 사양에 적기만 하면 새 기능도 자연스럽게 추가된다.
정리
Simon Martinelli의 Spec-driven Development는 AI 기반 소프트웨어 개발에 대한 실무적이고 검증된 접근법을 제시한다. 화이트 코딩의 한계를 명확히 인정하면서도, 그것을 넘어서는 방법을 구체적으로 보여준다.
Thomas Schilling의 세션(CLAUDE.md + Skills + Hooks)이 에이전트 도구 셋업에 집중했다면, Simon의 세션은 프로세스와 방법론에 집중한다. 두 발표를 함께 보면 AI 기반 개발의 전체 그림이 그려진다:
1
2
3
4
5
6
7
8
Thomas Schilling          Simon Martinelli
├─ CLAUDE.md              ├─ 유스케이스 명세
├─ Skills                 ├─ AI Unify Process
├─ Hooks                  ├─ 브라운필드 역추출
├─ MCP                    ├─ 테스트 전략
└─ 멀티 에이전트            └─ 아키텍처 가이드
         ↓                        ↓
         [     실무 AI 개발     ]
결국 두 발표가 가리키는 핵심은 같다: “The speed is free, but the discipline is yours.” 속도는 AI가 주지만, 규율은 여전히 우리의 몫이다.
원본 영상: Spec-driven Development — Simon Martinelli @ Spring I/O 2026